12개 SaaS가 함께 쓰는 LangGraph 서버를 설계하며 생긴 일들
시리즈 Claude Code 워크플로 현재 위치 31 / 31
- git worktree로 AI 세션 여러 개를 동시에 돌리기: 브랜치 충돌과 stash 공유 사고를 피하는 운영 규칙
- AI에게 기억을 심는 법: 메모리 파일로 삽질 교훈을 세션 간에 유지하기
- 스킬로 반복 작업 자동화: 이슈 착수부터 종료까지 한 명령으로 묶은 dev-issue 사례
- 코드 그래프(graft)로 AI의 탐색 비용 줄이기: grep/read 대비 토큰 절감 체감
- AI 코드 리뷰를 규칙으로 고정하기
- 반복되는 Git 워크플로우와 브랜치 정리 자동화
- 같은 요청을 여러 저장소에 반복하는 법: 한 줄 프롬프트 + 기준 문서 하나
- 이슈 하나를 한 줄로 개발 끝내는 법 — 내가 가장 많이 쓰는 Claude Code 스킬들
- 블로그 글을 스무 번 부탁하고 나서, 스킬로 만들었다
- 마라톤 세션이 토큰을 먹는 구조: 로그로 찾고, /compact와 서브에이전트로 줄이기
- 1인 개발자가 클로드코드로 SaaS 11개 만든 기록
- 이슈 하나에 30~60분, 어디서 새고 있었나: skill-creator로 dev-issue 스킬을 만든 과정
- 도면을 AI에게 읽히려다 AI를 뺀 이야기
- 스쿼시 머지 vs 머지 커밋: 1인 개발자의 PR 전략
- "난이도가 높아서 오래 걸리는 거야?" — AIFid 개발 기록으로 따져 본 소요 시간
- 엑셀 간편장부를 웹 ERP로 옮기기 (AICassa)
- Impeccable 스킬 적용한 게시글 상세 화면 구조 개선
- CLAUDE.md로 팀 규칙을 AI에게 가르치는 법
- AI티 나는 디자인 패턴 걷어내기: overused-font 훅 오탐 처리와 접근성 대비 수정
- CI4 브랜드 에러 페이지: 설계서 한 장에서 구현까지
- Claude에 MCP로 디자인 툴 붙이기 — DesignCraft·PhotoCraft 설치부터 명함, 카툰 효과까지
- AI 실수 복구: 메인 체크아웃을 dev 상태로 되돌린 기록
- 870줄 CLAUDE.md를 116줄로 줄인 실전 리팩터링
- AI로 AI 강의안을 만들다 — 실용인문학 5·6강 준비기
- Claude Code 토큰 절감 실전: 3개월 로그 분석과 5단계 전략
- 개발 기록을 재료로 AI가 쓰는 블로그 글 만들기
- Claude Vision으로 영수증·세금계산서 자동 장부 입력 구현
- AI가 만든 실제 실수 4가지 패턴과 교훈
- GitHub 이슈·PR 기반의 월간 작업일지 자동 생성 Claude 스킬 만들기
- Fable 5.2로 스킬 5개 토큰 45% 절감하기
- 12개 SaaS가 함께 쓰는 LangGraph 서버를 설계하며 생긴 일들
시리즈 제품 개발기 현재 위치 23 / 23
- 엑셀 간편장부를 웹 ERP로 옮기기 (AICassa)
- 혼자 쓰는 맛집 앱 Pagus 만들기
- 감으로 잡던 견적을 코드로: CNC 목공과 AILign 개발 이야기
- AIPicto: 도연님의 그림책을 위한 온라인 구독 플랫폼
- PHP 개발자, TypeScript와 R3F로 3D 가구 배치 앱 만들기
- 녹화형 AI 화상면접 솔루션 기획 노트 — AILego
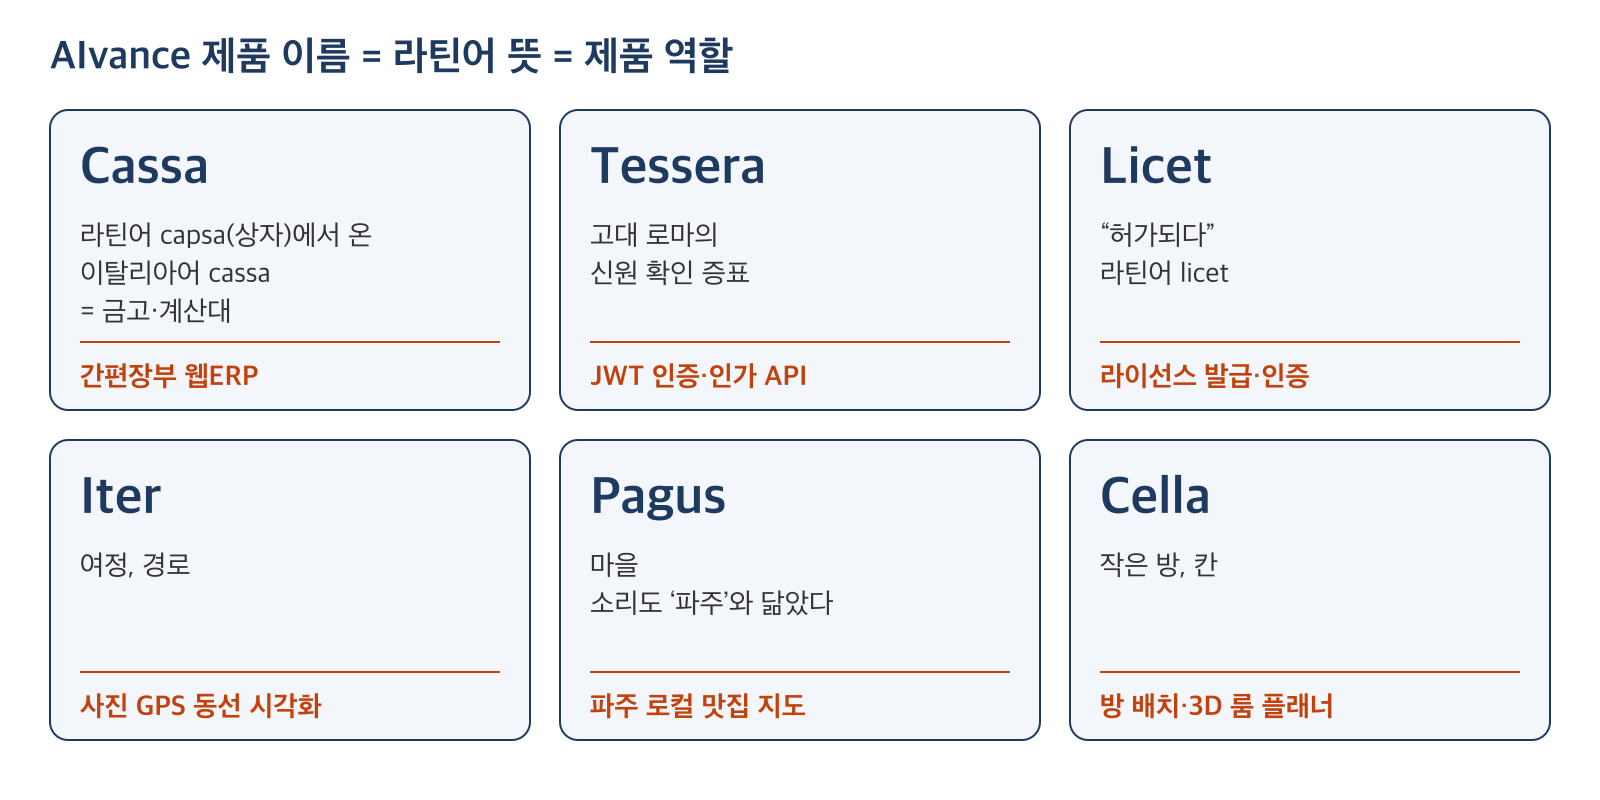
- AIvance 제품 이름은 왜 라틴어일까: Cassa에서 Cella까지
- 1인 개발자가 11개 SaaS를 운영하는 비밀: 공통 골격과 MSA 분할 전략
- "난이도가 높아서 오래 걸리는 거야?" — AIFid 개발 기록으로 따져 본 소요 시간
- 개별로는 통과하는데 전체에서만 죽는다 — AIFid 테스트 스위트가 composer test를 멈춘 날들
- 1인 개발자가 클로드코드로 SaaS 11개 만든 기록
- 도면을 AI에게 읽히려다 AI를 뺀 이야기
- 팬리스 우분투로 DC 모터를 인터넷에서 제어하기
- 저장소 아키텍처를 archify로 그려 README에 링크한 날
- Apache 403 해결과 php spark 로 슈퍼관리자 자동 발급하기
- UX와 보안을 동시에 잡는 그림책 게스트 열람 방안
- 혼자 하는 유지보수, 단가와 한도를 어떻게 정할까
- SEO + GEO 동시 적용: 정적 페이지에서 AI 검색 노출까지 한 방법
- 코어를 건드리지않고 확장하는 CodeIgniter 4 플러그인 구조와 핵심 설계 포인트
- GitHub 이슈·PR 기반의 월간 작업일지 자동 생성 Claude 스킬 만들기
- 경쟁자 4곳 분석으로 도출한 aiVelo MVP 로드맵
- 3일간 75커밋으로 완성한 AI 면접 플랫폼 AISensus 개발기
- 12개 SaaS가 함께 쓰는 LangGraph 서버를 설계하며 생긴 일들
2026년 11월 15일 · @martin
왜 공용 서버인가
저장소가 12개다. 대부분 CodeIgniter 4로 만든 SaaS다. 최근 그중 하나에 LangGraph를 붙였다. 분기하고, 되돌아가고, 중간에 사람이 승인해야 하는 AI 작업을 안정적으로 돌리려면 그래프가 필요했다.
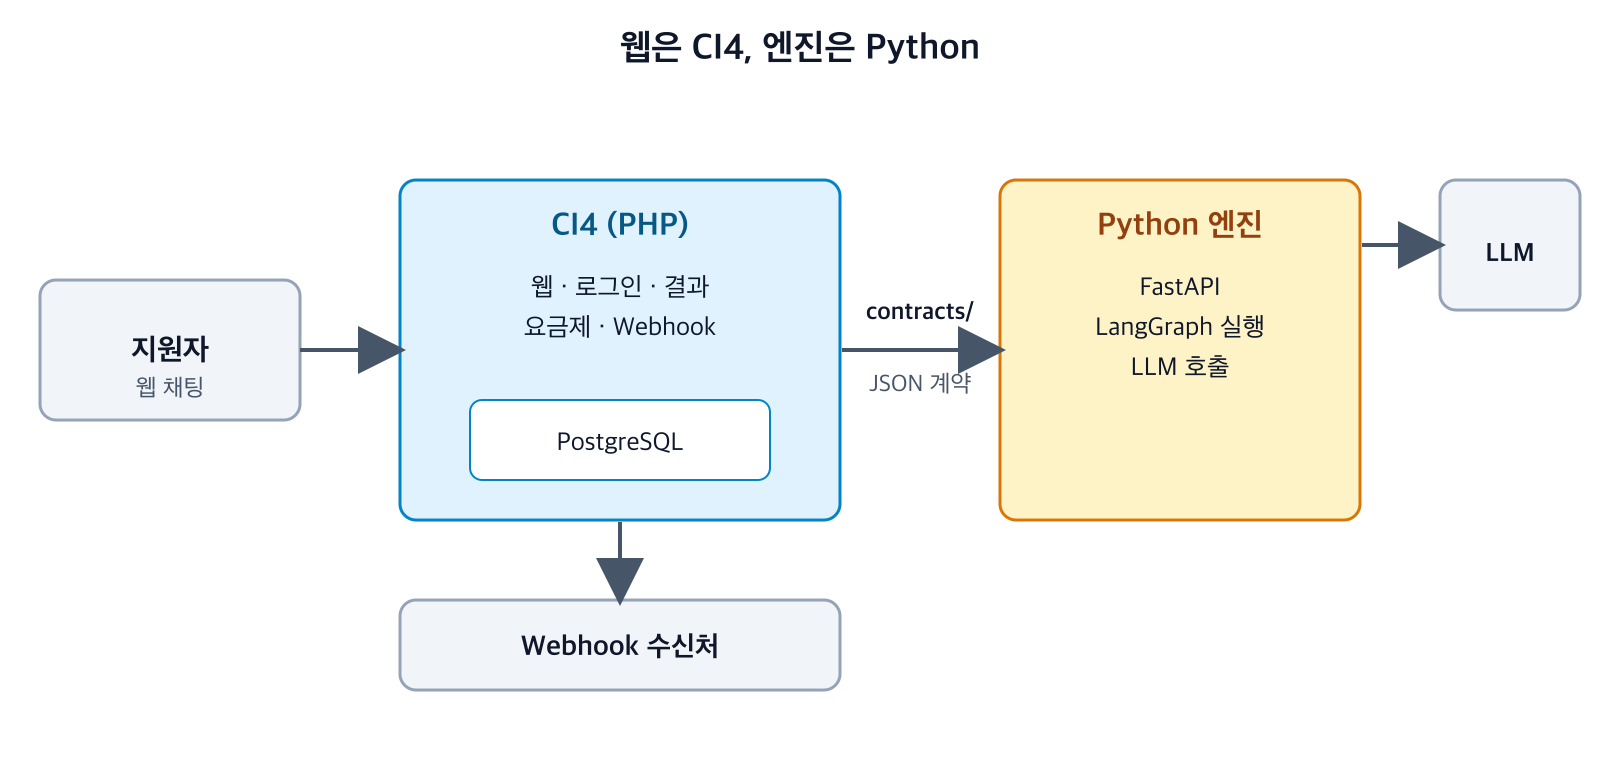
문제는 그 다음이었다. 다른 솔루션에도 쓰고 싶었다. 그런데 LangGraph는 Python이고 내 솔루션은 전부 PHP다. 솔루션마다 Python을 붙이면 배포도 12번, 업그레이드도 12번이다. 1인 개발자가 감당할 수 있는 숫자가 아니다.
그래서 LangGraph 전용 서버를 하나 두고, 12개 솔루션이 HTTP로 부르는 구조를 만들기로 했다. 이름은 AIGraph. 이 글은 조사부터 배포 설계까지 하루 만에 방향이 몇 번이나 바뀐 기록이다. 설계는 Claude와 대화하면서 문서로 만들었는데, 돌이켜 보면 결정을 바꾼 건 대부분 내가 던진 짧은 질문들이었다.
에피소드 1. 오픈소스인데 서버는 무료가 아니었다
처음엔 당연히 LangGraph 공식 서버를 쓰면 된다고 생각했다. assistants, threads, runs 같은 API와 스트리밍, 재시작 후 이어 실행까지 다 들어 있다.
조사해 보니 함정이 있었다. LangGraph 라이브러리는 MIT라 마음대로 쓸 수 있다. 하지만 그걸 HTTP로 서빙하는 공식 서버(지금은 LangSmith Deployment라고 부른다)는 사정이 다르다. 운영 환경에 셀프호스팅하려면 엔터프라이즈 라이선스 키가 필요하다. LangChain 포럼에도 “오픈소스라고 해서 골랐는데 키 없이는 못 띄우느냐”는 질문이 올라와 있었다. 무료 개발자 플랜은 월 10만 노드 실행까지다. 클라우드로 가면 노드마다 과금되는데, 에이전트가 루프를 돌 때마다 노드 수가 불어난다.
월 3~5만원짜리 정액제 SaaS 여러 개를 운영하는 입장에서는 둘 다 맞지 않았다. 그래서 첫 설계안의 결론은 “FastAPI로 서버를 직접 만들자”였다. 라이브러리는 무료니 그 위에 필요한 API만 올리면 된다는 생각이었다. 문서 한구석에는 같은 API를 무료로 구현한 오픈소스 Aegra도 적혀 있었다. 다만 “참고용”이라는 꼬리표가 붙어 있었다.
에피소드 2. “Aegra 쓰면 편한데 왜 직접 만들어?”
문서를 읽다가 걸렸다. Aegra는 Apache 2.0 오픈소스고, LangGraph 공식 SDK가 그대로 붙는 Agent Protocol 서버다. 필요한 걸 이미 다 갖고 있는데 왜 내가 새로 짜야 하지? 그래서 물었다. “Aegra를 쓰는 게 새로 개발하지 않고 편한데, 직접 만드는 걸 추천한 이유가 뭐야?”
돌아온 답은 생각보다 솔직했다. 추천이 과했다는 것이다. 직접 만들자고 했던 이유는 세 가지였다.
- 작은 외부 프로젝트에 기대면 방치될 위험이 있다.
- 12개 솔루션을 나눠 주는 멀티테넌시가 기본으로 없다.
- 내 응답 래퍼
{ status, data, message }형식으로 응답하지 않는다.
하나씩 뜯어보니 어느 것도 Aegra를 포기할 이유가 아니었다. Aegra는 공식 프로토콜을 따르니 멈추면 서버만 갈아끼우면 된다. 멀티테넌시는 인증 핸들러에서 구현하면 되는데, 직접 만들어도 어차피 똑같이 짜야 하는 코드다. 응답 형식은 PHP 클라이언트에서 바꾸면 끝이다. 반대로 직접 만들면 threads, runs, SSE 스트리밍, 중단 후 재개, Postgres 연동을 거의 그대로 다시 짜게 된다.
방향을 바꿨다. Aegra를 버전 고정해 띄우고, 그 위에 내가 필요한 것만 얹는다. 구현 로드맵의 첫 단계가 절반으로 줄었다. AI가 내놓은 추천도 한 번 떠보면 바뀔 수 있다는 걸 다시 느꼈다.
에피소드 3. Aegra에 없는 두 가지
Aegra 문서의 기능 지원표를 열어 보니 내가 채워야 할 빈칸이 정확히 보였다. threads, runs, 스트리밍, 사람 승인 후 재개, 크론, 커스텀 라우트는 지원한다. 그런데 두 가지가 “계획 없음”이었다.
- 멀티테넌시: 한 배포 안에서 테넌트를 나눠 주는 기능이 없다. 12개 솔루션이 서로의 대화를 볼 수 있다는 뜻이다.
- 웹훅: 오래 걸리는 작업이 끝났을 때 솔루션에 알려 주는 기능이 없다.
멀티테넌시는 Aegra의 인증 핸들러로 풀었다. 핸들러가 dict를 돌려주면 Aegra가 그걸 검색·조회·삭제에 필터로 건다. 그래서 스레드를 만들 때 메타데이터에 tenant를 찍고, 모든 스레드 접근에 “내 tenant만”이라는 필터를 돌려주게 했다. run을 만들 때는 그 솔루션이 쓸 수 있는 그래프인지, 이번 달 한도를 넘지 않았는지도 여기서 본다. Python 파일 하나, auth.py가 문지기다.
웹훅은 방향을 바꿔 풀었다. 서버가 알려 주지 못하면 그래프가 알리면 된다. 백그라운드로 도는 그래프는 마지막에 공용 notify 노드를 두고, 이 노드가 솔루션의 콜백 URL로 서명한 요청을 보낸다. 실패하면 세 번까지 다시 보낸다.
직접 만드는 건 결국 이 두 가지와 테넌트별 사용량 집계뿐이다. 서버 전체를 짤 때와 비교하면 일의 양이 훨씬 적다.
에피소드 4. “JWT는 Aegra에 있지 않아?”
설계 문서에는 솔루션이 JWT를 만들어 보내고 서버가 검증한다고 적혀 있었다. Aegra 소개에 “JWT, OAuth, Firebase 지원”이라는 문구를 봤던 게 생각나서 물었다. JWT는 Aegra 자체에 있는 거 아니냐고.
확인해 보니 반만 맞았다. Aegra에는 켜기만 하면 되는 JWT 모드가 없다. 인증 가이드의 JWT는 사용자가 직접 쓰는 핸들러 예제고, 토큰을 발급하는 기능도 없다. “검증하는 함수는 당신이 쓰고, 나머지는 Aegra가 처리한다”는 구조다.
마침 자체 인증 API인 AITessera가 있어서 그걸 붙일지도 후보로 올라와 있었다. 그런데 크게 벌리고 싶지 않았다. 그래서 가장 작은 방식으로 정했다.
- 테넌트마다 비밀키 하나를 서버와 그 솔루션에 똑같이 넣는다.
- 솔루션이 요청마다 5분짜리 HS256 토큰을 만든다. 클레임은
tenant,sub,iat,exp네 개다. - 서버는 PyJWT로 서명과 만료만 확인한다.
리프레시 토큰도, 인증 서버도, AITessera도 없다. 나중에 통신이 전부 내부망에서만 오가게 되면서 비밀키 정기 교체 계획도 뺐다. 필요 없는 보안 장치는 운영할 것만 늘린다.
에피소드 5. 저장소는 하나, 그런데 미러가 떠다닌다
저장소는 aivance/aigraph 하나로 하고, 안에서 서버와 PHP 클라이언트를 디렉터리로 나누기로 했다. 요청을 보내고 보니 서버 디렉터리 이름을 aegra로 적었다. 실제 이름은 agera다. “오타야, agera야”라고 보냈더니 저장소 이름을 바꿀지 디렉터리 이름을 바꿀지 되물어 왔다. 두 단어가 너무 비슷해서 어느 쪽이 오타인지 헷갈릴 만했다. 결국 aivance/aigraph 아래 agera/와 client/로 정리됐다.
더 큰 오해는 그 다음에 있었다. Composer는 저장소 루트의 composer.json만 읽기 때문에 하위 디렉터리를 VCS 패키지로 바로 설치하지 못한다. 그래서 문서에는 client/만 잘라 별도 미러 저장소로 밀어 넣는 방식이 들어가 있었다. 저장소를 하나로 하자고 했는데 하나가 더 생긴 셈이다. “저장소 따로 안 둔다니까, 왜 안 고쳐?”라고 물을 수밖에 없었다.
해법은 운영 환경에 있었다. 12개 솔루션이 전부 같은 운영 서버에 있다. 그러면 운영 서버에 aivance/aigraph를 한 번 클론해 두고, 각 솔루션이 Composer path 저장소로 /srv/aigraph/client를 설치하면 된다. 미러도 패키지 서버도 필요 없다. 다만 Composer 규칙 때문에 남는 차이가 두 가지 있다. 패키지 이름은 vendor/name 두 부분만 되므로 aivance/aigraph로 두었다. 또 path 저장소는 git 태그를 버전으로 읽지 못해서 composer.json의 version을 직접 올린다.
에피소드 6. 집 러너 서버에 다 올리기
배포는 집에 있는 우분투 서버에 하기로 했다. GitHub Actions 셀프호스티드 러너 3대가 돌고 있는 그 서버다. agera, PostgreSQL, Redis를 Docker Compose 하나로 묶고, 러너가 같은 서버에 있으니 SSH 없이 워크플로에서 바로 docker compose up을 돌린다.
agera는 두 개를 띄운다. 배포할 때 하나씩 교체하면 그동안 다른 하나가 요청을 받는다. 상태는 전부 PostgreSQL과 Redis에 있어서 어느 쪽으로 가도 같은 결과가 나온다. 여러 개를 띄울 때는 시작 시 자동 마이그레이션을 끄고, 배포 때 한 번만 돌리라는 게 Aegra 문서의 안내다.
여기에 트레이싱용 Langfuse도 추가했다. 그런데 Langfuse는 생각보다 무겁다. v2 때는 PostgreSQL 하나면 됐는데, 지금 공식 Compose는 web, worker, PostgreSQL, Redis, ClickHouse, MinIO까지 여섯 개다. 한 대에 올리려면 16GB를 권장하는 가이드도 있었다.
서버에서 top을 찍어 봤다. 총 15.4GB에 잔여 1.5GB. 잠깐 걱정했지만 실제 사용은 3GB뿐이었고 나머지 11.4GB는 버퍼와 캐시였다. 캐시는 필요하면 커널이 돌려주므로 실제 여유는 약 12GB다. 들어가기는 하지만 러너 빌드가 겹치면 빠듯하다. 그래서 컨테이너마다 메모리 상한을 걸었다.
|
컨테이너 |
메모리 상한 |
|---|---|
|
agera 2개 |
각 1GB |
|
PostgreSQL / Redis (agera) |
1GB / 512MB |
|
Langfuse ClickHouse |
3GB |
|
Langfuse 나머지 5개 |
합계 약 3.3GB |
|
합계 |
약 9.8GB |
상한을 다 채워도 2GB가 남고, 스왑 4GB를 더 둔다. 운영 초기 2주는 docker stats를 보면서 조정할 생각이다. Langfuse는 디버깅과 비용 분석에만 쓴다. 한도를 넘었는지 막는 판단은 agera가 직접 한다. Langfuse가 멈춰도 서비스는 돌아야 하기 때문이다.
에피소드 7. “서버가 다른데 hosts 한 줄로 돼?”
솔루션은 운영 서버에 있고 agera는 집 러너 서버에 있다. 둘을 어떻게 잇느냐가 마지막 문제였다. 맥북, 운영 서버, 러너 서버에는 이미 전부 Tailscale이 깔려 있었다. 그래서 agera는 러너 서버의 Tailscale IP에만 포트를 열고, 운영 서버의 Apache가 그쪽으로 요청을 넘기게 했다. 공유기 포트포워딩은 필요 없고, 구간은 Tailscale이 암호화한다.
하나 배운 게 있다. Docker가 연 포트는 UFW가 막지 못한다. 접근 제한은 방화벽이 아니라 바인딩 주소와 Tailscale ACL로 해야 한다. 또 서버를 재부팅할 때 Docker가 Tailscale보다 먼저 뜨면 그 IP가 아직 없어서 컨테이너가 포트를 못 연다. docker.service에 After=tailscaled.service를 걸어 둔다.
12개 솔루션이 전부 운영 서버에 있다는 걸 확인하고 나서는 한 발 더 나갔다. graph.aivance.kr을 아예 인터넷에 공개하지 않기로 했다. Apache 가상호스트를 127.0.0.1에만 열고, 운영 서버 /etc/hosts에 127.0.0.1 graph.aivance.kr 한 줄을 넣는다.
여기서 고개가 갸웃했다. 운영 서버랑 러너 서버가 다른데 127.0.0.1로 어떻게 러너에 가지? 답은 단계를 나눠 보면 나온다.
- 솔루션이
graph.aivance.kr을 부른다. - 운영 서버의 hosts 때문에 이 이름은 운영 서버 자신의 Apache로 간다.
- Apache가 설정에 적힌 러너 서버 Tailscale IP의 agera 두 개로 나눠 보낸다.
이름을 주소로 바꾸는 건 1→2 구간뿐이고, 러너 서버는 이 이름을 몰라도 된다. 요청은 인터넷에 한 번도 나가지 않고, TLS 인증서도 필요 없다. 한 가지만 주의하면 된다. 솔루션이 Docker 컨테이너 안에서 돌면 127.0.0.1은 컨테이너 자신이다.
마치며
하루 동안 정리된 최종 구조는 이렇다.
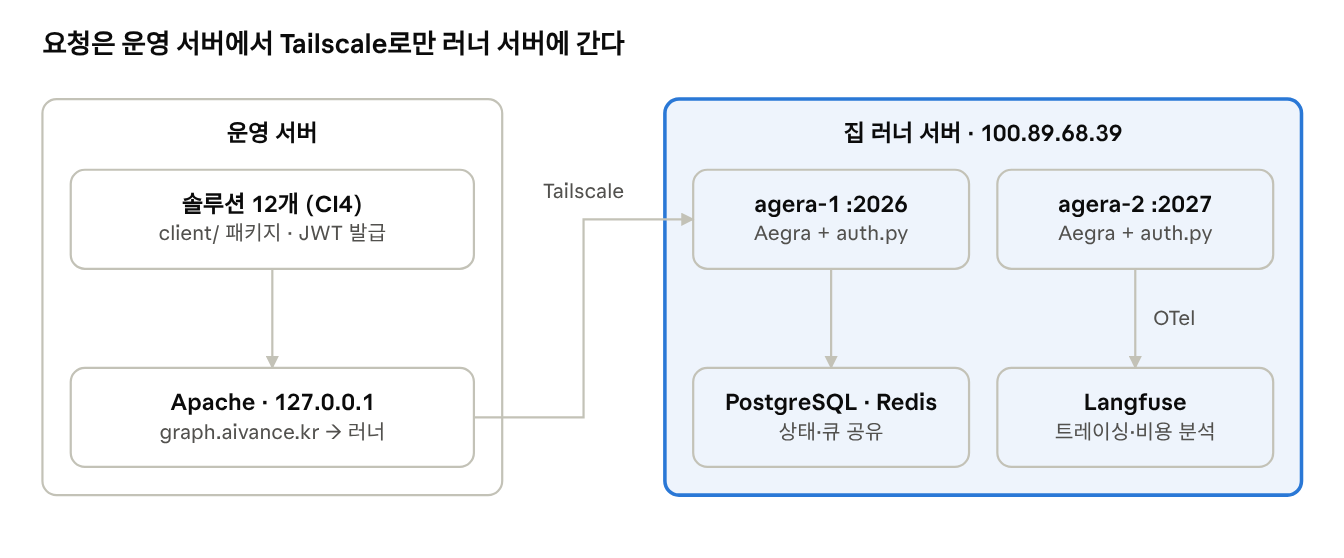
솔루션은 운영 서버 안에서만 호출하고, Apache가 Tailscale을 통해 집 러너 서버의 agera 두 개로 나눠 보낸다. 상태는 PostgreSQL과 Redis가, 트레이스는 Langfuse가 갖는다.
설계 문서는 처음 쓴 뒤 여덟 번 넘게 바뀌었다. 돌이켜 보면 방향을 바꾼 건 거창한 검토가 아니었다.
- “Aegra 쓰면 편한데 왜?” — 서버를 새로 만드는 계획이 없어졌다.
- “JWT는 Aegra에 있지 않아?” — 검증은 내가 짠다는 걸 알고 최소로 줄였다.
- “저장소 따로 안 둔다니까” — 미러 저장소가 사라지고 path 저장소가 됐다.
- “서버가 다른데 돼?” — 요청이 지나가는 길을 한 줄씩 따라가 봤다.
AI와 설계할 때 가장 쓸모 있는 건 짧은 의심이었다. 내 환경(솔루션이 전부 한 서버에 있다, 세 장비가 이미 Tailscale로 묶여 있다)을 한 줄 알려 줄 때마다 설계가 눈에 띄게 단순해졌다. 일반론으로 시작한 설계는 내 사정을 넣을수록 작아진다.
다음 글에서는 실제로 agera/를 띄우고 첫 솔루션을 옮겨 본 이야기를 쓸 생각이다.
댓글 0
아직 댓글이 없습니다. 첫 댓글을 남겨 보세요.