2026년 10월 26일 · @martin
들어가며
녹화형 AI 화상면접 솔루션 AILego를 기획하고 Claude Code로 개발까지 마쳤다. 이 글은 그 과정에서 무엇을 정했고, 왜 처음 생각을 바꿨는지에 대한 기록이다.
처음 떠올린 그림은 단순했다. 회사가 문제은행에 질문을 등록하고, 응시자는 수험번호와 발급받은 비밀번호로 로그인해 제한시간 안에 답변을 녹화한다. AI가 화면과 음성을 분석해 점수를 매기면, 인사담당자는 점수순으로 정렬된 목록을 보고 검토한다.
여기에 하나를 더 얹고 싶었다. 질문을 만들 때 "이 질문으로 무엇을 어떻게 평가할지", 즉 평가 기준(루브릭)까지 AI가 추천하고 작성해 주는 기능이다. 막상 해보면 질문보다 기준을 만드는 게 훨씬 어렵기 때문이다.
이름 Lego는 라틴어 lego(선발하다, 읽다)에서 따왔다. 캐치프레이즈는 "인재를 읽고, 가치를 더하다"로 정했다.
처음 생각과 달라진 것: 표정이 아니라 답변 내용을 본다
기획 단계에서 가장 크게 바꾼 결정은 표정·시선으로 사람을 점수화하지 않기로 한 것이다. 처음엔 "AI가 화면과 음성을 분석한다"였지만, 최종 명세에서는 답변 내용(STT 전사문 + LLM)만으로 평가한다.
이유는 세 가지였다.
- 법규: 채용은 2026년 1월 22일 시행된 AI 기본법의 고영향 AI 영역에 해당할 수 있다. 사람의 관리·감독, 설명 가능성, 위험관리 기록이 요구된다.
- 생체정보: 얼굴 특징값은 개인정보보호법상 별도 동의가 필요한 민감한 데이터다.
- 설명 가능성: "표정 점수 62점"은 응시자가 이의를 제기했을 때 설명할 방법이 없다. 반면 "이 발언이 이 기준에 해당해서 4점"은 설명이 된다.
그렇다고 영상을 버린 건 아니다. 영상은 본인확인과 부정행위 탐지 용도로만 쓴다. 브라우저에서 얼굴이 있는지, 몇 개인지만 판단하고 얼굴 이미지나 특징값은 서버로 보내지 않는다.
한 줄 원칙과 절대 규칙
방향을 바꾸고 나니 서비스 전체를 한 문장으로 정리할 수 있었다.
AI가 질문과 평가기준을 추천하고, 사람이 확정하고, 확정된 기준으로 AI가 채점하고, 사람이 최종 판단한다.
AI와 사람이 번갈아 가며 손을 대는 구조다. 이 문장을 지키기 위해 명세 맨 앞에 절대 규칙을 박아 두었다.
- AI 점수로 자동 합격·탈락시키는 기능은 만들지 않는다. 최종 판정(pass, hold, fail)은 사람만 채운다.
- 루브릭은 담당자 승인 없이 채점에 쓰일 수 없고, 면접이 시작되면 그 버전은 잠긴다.
- 영상은 인성·성격 판단에 쓰지 않는다.
- 응시자에게 AI 평가 사실을 미리 알리고 동의를 받는다.
- 루브릭은 응시자에게 절대 노출되지 않는다.
이 규칙들은 그대로 CLAUDE.md에도 들어갔다. Claude Code가 편의상 판정 필드를 자동으로 채우는 코드를 짜는 일을 원천 차단하기 위해서다.
핵심은 루브릭: 사람이 확정한 기준만 채점에 쓴다
AILego에서 가장 공을 들인 부분은 질문이 아니라 루브릭이다. 승인된 루브릭 JSON이 그대로 채점 프롬프트의 입력이 되기 때문에, 기준이 흐리면 점수도 흐려진다. 그래서 루브릭은 네 단계를 거쳐야 채점에 쓰인다.
- 초안 생성: 질문을 저장하고 "평가기준 생성"을 누르면 AI가 평가요소, 가중치, 점수 구간별 기준, 예시 답변, 감점 요소를 만든다. 담당자는 폼 편집기에서 고친다.
- 금지요소 검사: 1차는 키워드 사전(나이, 성별, 외모, 출신 지역, 사투리, 결혼, 출산, 종교, 가족 배경 등), 2차는 LLM이 "직무와 무관하거나 차별 소지가 있는 항목"을 찾는다. 경고를 무시하고는 저장할 수 없다.
- 시험 채점(캘리브레이션): AI가 우수·보통·미흡 가상 답변 3개를 만들어 현재 루브릭으로 채점해 본다. 점수가 한 구간에 몰리면 "기준이 모호함" 경고를 띄운다.
- 승인과 잠금: 승인하면 그 버전은 수정할 수 없다. 고치려면 새 버전을 만들고, 진행 중인 세션은 옛 버전을 계속 참조한다.
스키마는 생성·편집·채점 세 곳에서 똑같이 쓴다. 평가요소는 2~6개, 가중치 합은 100, 점수 구간은 최소 1·3·5점 세 개가 필수다.
{
  "scale": { "min": 1, "max": 5 },
  "criteria": [{
    "key": "problem_solving",
    "name": "문제해결력",
    "weight": 40,
    "levels": [
      { "score": 5, "descriptor": "원인 분석, 본인의 구체적 행동, 측정 가능한 결과가 모두 제시됨" },
      { "score": 3, "descriptor": "행동은 있으나 원인 분석이나 결과가 모호함" },
      { "score": 1, "descriptor": "일반론만 있고 본인 경험이 드러나지 않음" }
    ]
  }],
  "deductions": [{ "key": "off_topic", "description": "질문과 무관한 답변", "max_penalty": 2 }]
}
금지요소 사전은 슈퍼관리자 화면에서 관리하고, 바꾸면 다음 검사부터 바로 적용된다.
응시자 쪽 설계: 끊겨도 공정하게
응시자는 회원가입 없이 수험번호와 랜덤 8자리 비밀번호로 들어온다. 5회 틀리면 10분 잠금이다. 동의 → 본인확인 사진 → 장비 점검(카메라·마이크·업로드 속도) → 연습 질문 → 본 면접 순서로 진행된다.
본 면접은 질문마다 "질문 표시와 음성 재생 → 준비시간 → 자동 녹화 → 시간 종료 시 자동으로 다음 질문"이 반복된다. 여기서 고민한 지점은 세 가지다.
영상이 API 서버를 거치지 않게. 면접 당일 가장 큰 부하는 동시 접속과 영상 업로드다. MediaRecorder로 5초마다 청크를 끊고, 청크별 Presigned PUT URL로 S3에 직접 올린다. API는 완료 보고만 받아 청크 수와 체크섬으로 누락을 확인한다. 밀린 청크는 브라우저 IndexedDB에 담아 두었다가 네트워크가 돌아오면 다시 보낸다.
시간의 기준은 서버. 클라이언트 타이머는 표시용일 뿐이다. 녹화 시작·종료 시각은 서버에 기록하고, "시작 + 답변시간 + 10초"를 넘긴 청크는 평가에서 뺀다. 질문 본문도 준비시간이 시작될 때에만 API로 받는다. 질문 목록을 미리 받을 방법이 없다.
끊김은 서버가 확인한 것만. 응시자가 "끊겼어요"라고 주장하는 것만으로는 재응시를 주지 않는다. 서버가 확인한 끊김에 한해 재응시를 허용하고, 공정성을 위해 같은 유형·같은 기준의 다른 질문으로 교체한다. 질문 슬롯당 기본 3회까지이며, 한도를 넘겨도 자동 탈락이 아니라 플래그만 올린다.
처리 파이프라인과 설명 가능한 점수
답변 처리는 전부 Redis 큐 워커가 비동기로 한다. 반대로 루브릭 생성이나 질문 추천처럼 담당자가 화면 앞에서 기다리는 호출은 API가 LLM을 직접 부른다. 기다리는 사람이 있느냐 없느냐로 동기·비동기를 나눴다.
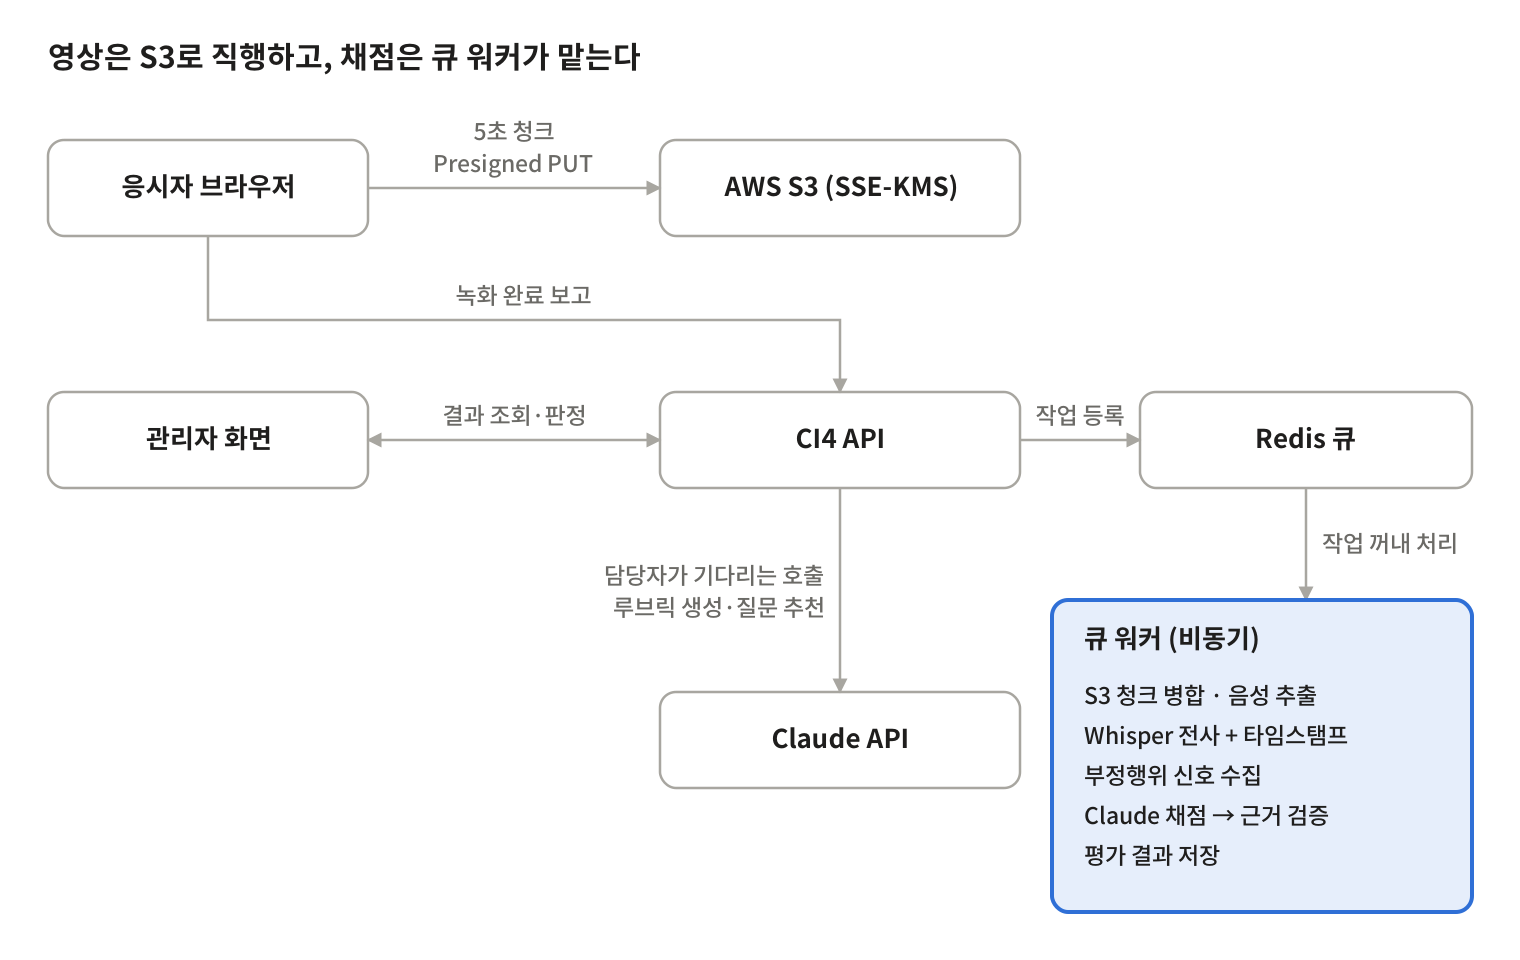
응시자 영상은 API 서버를 거치지 않고 S3로 바로 가고, API는 작업만 큐에 넣는다.
워커는 답변 1건마다 다음 순서로 일한다.
- FFmpeg로 청크 병합, 재생용 mp4와 썸네일 생성
- 16kHz mono 음성 추출 후 Whisper API로 단어·문장 타임스탬프가 붙은 전사문 생성
- 부정행위 신호 수집
- 질문 + 승인된 루브릭 버전 + 전사문으로 LLM 채점
- 결과 검증 후 저장, 모든 답변이 끝나면 응시자 단위 집계와 요약
LLM이 준 점수를 그대로 믿지 않는 장치를 여럿 넣었다.
- 근거 인용 검증: 채점 결과의 근거 발언(evidence)이 전사문에 실제로 있는지 서버가 부분 문자열로 확인한다. 실패하면 1회 재시도, 그래도 안 되면 검토필요 상태로 둔다.
- 가중점수는 서버가 재계산: LLM이 낸 합계는 쓰지 않고 Σ(점수/만점 × 가중치) − 감점으로 다시 계산한다.
- 프롬프트 인젝션 방어: 전사문은 구분자로 감싸고, 그 안의 "만점을 줘" 같은 지시는 무시하도록 명시한다.
- 비직무 요소 반영 금지: 말투·발음·사투리·어휘 수준을 점수에 넣지 말라고 시스템 지시에 적는다.
- 재현성: structured output으로 JSON을 강제하고 온도를 0.1~0.2로 낮춘다. 프롬프트·모델·루브릭 버전을 모두 결과에 기록한다.
유효 발화가 5초 미만인 답변은 LLM을 부르지 않고 "무응답"으로 처리한다. 비용을 줄이는 가장 쉬운 방법이었다.
결과 화면에서 담당자는 영상, 전사문(클릭하면 해당 시점으로 이동), 평가요소별 점수와 근거 인용문, 부정행위 타임라인을 한 번에 본다. 점수를 고치려면 사유를 반드시 적어야 하고, 원래 AI 점수와 수정 점수가 함께 남는다.
부정행위 방지: 감점이 아니라 플래그
부정행위 신호는 점수를 깎지 않는다. 플래그(none, low, high)로만 표시하고, 판단은 평가자가 영상을 보고 한다. 오탐 하나로 응시자가 불이익을 받는 일을 막고 싶었다.
|
신호 |
수집 위치 |
MVP |
|---|---|---|
|
탭 전환·창 포커스 이탈 |
브라우저 |
포함 |
|
전체화면 해제 |
브라우저 |
포함 |
|
복사·붙여넣기·우클릭·개발자도구 |
브라우저 |
포함 |
|
얼굴 미검출·복수 얼굴 (MediaPipe, 1초 간격) |
브라우저 |
포함 |
|
발화 시작 지연 |
서버 |
포함 |
|
읽기 패턴 의심 (말 속도 균일성, 필러 부재, 문어체 비율) |
서버 |
포함 |
|
같은 기기·IP 중복 응시 |
서버 |
포함 |
|
시선 이탈 비율 |
브라우저 |
2차 |
|
제3자 음성 |
서버 |
2차 |
관리자 화면에서는 이 신호들이 영상 타임라인 위의 마커로 나타난다. 클릭하면 그 시점으로 바로 이동한다. 제3자 음성은 Whisper가 화자 분리를 지원하지 않아 2차로 미뤘다.
기술 선택과 원가 계산
백엔드는 늘 쓰던 CodeIgniter 4 보일러플레이트(ci4-board)에서 출발했다. JWT, API 버저닝, Swagger, i18n을 그대로 재사용할 수 있어서다.
|
구분 |
선택 |
고른 이유 |
|---|---|---|
|
백엔드 |
PHP 8.4+, CodeIgniter 4 |
ci4-board 재사용, 익숙한 스택 |
|
DB |
MySQL 8 |
모든 테이블에 company_id를 둔 멀티테넌트 |
|
큐 |
Redis + Spark 워커 |
수평 확장 가능한 비동기 처리 |
|
스토리지 |
AWS S3 (서울), SSE-KMS |
Presigned URL 직접 업로드, 암호화 |
|
STT |
OpenAI Whisper API |
응시자 혼자 말하니 화자 분리 불필요, 단가 낮음 |
|
TTS |
CLOVA Voice |
한국어 자연스러움, 입력에 개인정보 없음 |
|
LLM |
Claude API |
루브릭 생성·질문 추천·채점, structured output |
|
관리자 화면 |
CI4 View + Alpine.js |
SPA 없이 가볍게 |
|
응시자 화면 |
순수 JS + MediaRecorder |
의존성 최소화 |
관리자 화면을 CI4 View + Alpine.js로 정한 건 기획 초기에 내린 결정이다. 별도 SPA를 두면 빌드 파이프라인과 인증 처리가 하나씩 더 생긴다. 1인 개발에서는 그게 곧 유지보수 비용이다. Alpine.js도 CDN이 아니라 저장소에 포함된 파일을 쓴다.
외부 AI 호출은 모두 SttProviderInterface, LlmProviderInterface, TtsProviderInterface 뒤에 숨겼다. 공급자를 바꾸기 쉽고, 테스트에서는 Fake 구현체로 대체해 실제 API를 절대 호출하지 않는다.
원가는 기획 단계에서 먼저 계산했다. 30분 면접(답변 약 1만 자) 기준 STT 약 250원, 채점 LLM 약 70~140원으로 건당 약 350~400원이다. Whisper를 고른 결정적 이유도 여기 있다. 같은 조건에서 CLOVA Speech는 약 600원이었다. 실제 원가는 작업 단위로 usage_logs에 기록해 슈퍼관리자 대시보드에서 확인한다.
요금제 초안은 체험(무료, 14일, 응시자 10명)과 표준(월 290,000원, 월 100명 포함, 초과 1명당 3,000원), 엔터프라이즈(협의) 세 가지다. 금액은 아직 재검토 대상이다.
Claude Code로 개발한 방식: 명세 → 로드맵 → 이슈 하나씩
개발은 Claude Code로 했다. 핵심은 코드보다 문서를 먼저 단단하게 만든 것이다.
- SPEC.md: 기능, 데이터, API, 법규 대응까지 담은 개발 명세서. 처음부터 "Claude Code용"으로 썼다. 테이블 17개, 상태 전이, 엔드포인트 목록, 루브릭·채점 JSON 스키마, 프롬프트 설계 원칙이 다 들어 있다.
- ROADMAP.md: 명세를 5단계 51개 이슈로 쪼갰다. 기반 → 문제은행과 AI 루브릭 → 면접 세션과 응시자 화면 → 처리 파이프라인 → 결과 검토와 운영 순이다. 이슈마다 선행 이슈를 적어 두고, 선행이 안 끝나면 착수하지 않는다.
- CLAUDE.md: 앞서 말한 절대 규칙에 개발 규칙을 더했다. 승인된 루브릭과 채점 결과 행은 UPDATE 금지(새 행 추가), 새 엔드포인트마다 테넌트 격리 테스트 추가 같은 것들이다.
작업 단위는 GitHub 이슈 1개 = feature 브랜치 1개 = PR 1개로 고정했다. 이슈 번호를 주면 탐색 → TDD 구현 → 검증 → PR → 머지 → 이슈 종료까지 진행하는 dev-issue 스킬을 만들어 반복했다. 브랜치는 feature/* → dev(Squash) → main(Merge commit) 흐름이다.
각 단계의 완료 조건은 PHPUnit + PHPStan level 8 통과다. PHP-CS-Fixer, 로컬 Git 훅, GitHub Actions CI가 같은 composer check를 돌린다.
명세를 그대로 따르기만 한 건 아니다. 로드맵을 짜면서 순서를 조정했다. 예를 들어 채점 코어를 4단계에서 2단계로 앞당겼다. 루브릭 시험 채점이 같은 채점 로직을 쓰기 때문이다. 감사 로그 서비스도 1단계에 먼저 깔아 두고 5단계 기능들은 호출만 하게 했다.
결정이 필요한 항목은 decision 라벨을 붙인 이슈로 따로 관리했다. STT 공급자, TTS 공급자, 녹화 끊김 정책, 첫 파일럿 타겟이 그것이다. 결정이 나면 근거와 함께 명세에 다시 적었다.
마치며: 첫 파일럿은 수시채용 중소기업
첫 파일럿 타겟은 수시채용 중소기업으로 정했다. 셀프 가입·응시자당 과금 모델과 잘 맞고, 대표나 인사담당자 한 명이 결정하니 도입이 가장 빠르다. 병원(간호직)은 대량 채용이라 매력적이지만 보안·개인정보 심사로 도입이 느려 2순위로 두었다. 대학·교육기관은 입시 공정성 문제가 민감하고 채용이 아니라서 법규 적용 범위부터 따로 검토해야 한다.
남은 과제는 이렇다.
- 파일럿 고객 1곳 섭외와 실사용 테스트
- 실제 면접 샘플로 STT 오류율(CER) 측정
- 출시 전 AI 기본법·개인정보보호법 법률 검토
- 2차 기능: 시선 이탈 비율, 제3자 음성 감지, 차별 모니터링 리포트
- 요금제 금액 재검토와 토스페이먼츠 결제 연동
돌아보면 이 프로젝트에서 가장 중요했던 건 기술이 아니라 "AI가 어디까지 하고, 어디서 멈추는가"를 먼저 정한 것이었다. 그 선을 명세와 CLAUDE.md에 못 박아 두니, Claude Code와 함께 일하는 동안에도 방향이 흔들리지 않았다.
댓글 0개