
한 줄 요약 — 로그 수집 API는 받은 것을 Redis에 넣고 바로 202를 돌려줍니다. 파일과 DB에 쓰는 일은 워커가 배치로 하고, 끝내 처리하지 못한 로그는 버리지 않고 dead-letter 큐에 모읍니다.
들어가며: 로그 한 줄이 요청을 붙잡고 있었다
AICura에는 앱 로그 분석 기능이 있습니다. 앱 사용자가 이벤트를 조회하고, 상담을 신청하고, 좋아요를 누르는 행동을 모아 시간별로 집계하고 관리자 대시보드에 보여 줍니다. 광고주인 병원과 대행사가 "광고를 보고 실제로 무엇을 했는가"를 확인하는 화면입니다.
처음 구조는 단순했습니다. 프론트가 로그를 보내면 컨트롤러가 검증하고 그 자리에서 INSERT 합니다. 사용자가 적을 때는 문제가 없었지만, 이 구조에는 약점이 세 가지 있었습니다.
- 로그가 본 기능의 속도를 잡아먹는다. 화면을 넘길 때마다 로그 요청이 나가는데, 그 요청이 DB 쓰기를 기다립니다. DB가 잠깐 느려지면 로그 API도 같이 느려지고, PHP 워커가 그 요청들에 묶입니다.
- 실패한 로그가 조용히 사라진다. DB 오류가 나면 500을 돌려줄 뿐, 그 로그는 어디에도 남지 않습니다. 프론트가 재시도하지 않으면 끝입니다.
- 원본이 없다. 집계 기준을 바꾸고 싶어도 DB에 들어간 형태 외에는 원래 받은 데이터가 없어서 다시 계산할 수 없습니다.
그래서 받는 일과 저장하는 일을 떼어 냈습니다. 이 글은 그 파이프라인을 어떤 순서로 만들었고, 각 단계에서 무엇을 지키려 했는지 정리합니다. 스택은 기존과 같은 CodeIgniter 4, PHP 8.4+, MySQL 8, Redis입니다.
전체 구조
수집 API는 Redis에 넣는 데서 일을 끝내고, 저장과 실패 처리는 전부 큐 뒤의 워커가 맡습니다.
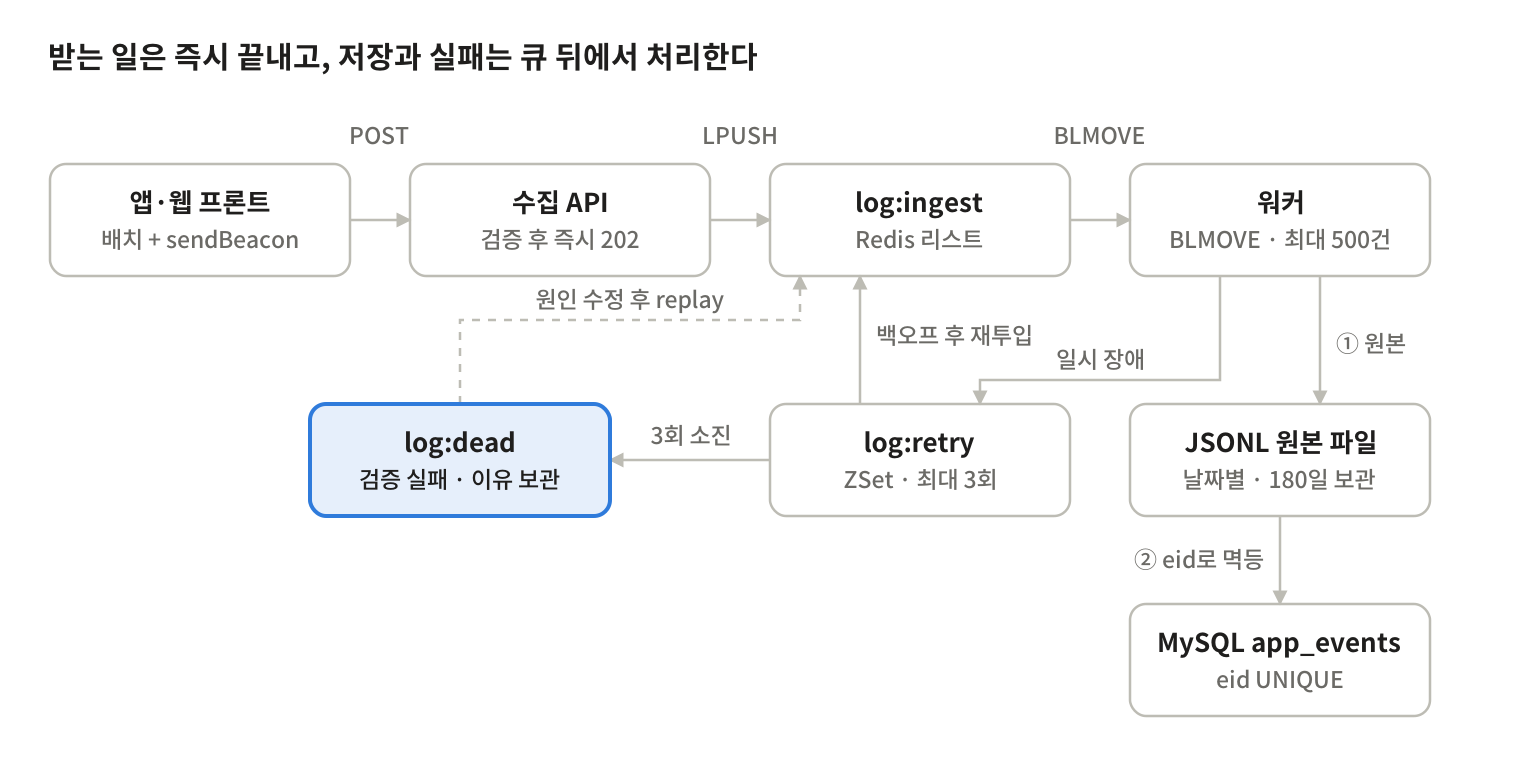
윗줄이 요청 경로, 오른쪽 세로줄이 저장 경로, 가운데와 왼쪽이 실패 경로입니다. 어느 경로로 가든 로그는 사라지지 않고 DB, 재시도 대기, dead-letter 중 한 곳에 남습니다.
1단계 수집 API: 검증만 하고 즉시 202
수집 API가 하는 일은 "받았다"는 약속까지입니다. 저장이 끝났다는 뜻의 201이 아니라, 접수했고 나중에 처리한다는 뜻의 202 Accepted를 돌려줍니다.
요청 안에서 하는 일은 네 가지뿐입니다.
- 본문 크기를 확인한다 (64KB 초과는 413).
- 이벤트 배열을 꺼내 최소 형식만 본다. 이벤트 이름, 발생 시각, 이벤트 수 50개 이하.
- 이벤트마다 서버에서
eid(ULID)와 수신 시각을 붙인다. - Redis 리스트에 한 번에 밀어 넣고 202를 돌려준다.
// app/Controllers/Api/V1/EventIngest.php
final class EventIngest extends BaseController
{
    private const MAX_BODY   = 65536;
    private const MAX_EVENTS = 50;

    public function create(): ResponseInterface
    {
        $raw = (string) $this->request->getBody();
        if (strlen($raw) > self::MAX_BODY) {
            throw ApiException::of('LOG.PAYLOAD.TOO_LARGE', 413);
        }

        $events = json_decode($raw, true)['events'] ?? null;
        if (! is_array($events) || $events === [] || count($events) > self::MAX_EVENTS) {
            throw ApiException::of('COMMON.VALIDATION.FAILED', 422);
        }

        $queue = service('eventQueue');
        if ($queue->isOverloaded()) {          // 백프레셔: 6장
            return $this->response->setStatusCode(503)->setHeader('Retry-After', '30');
        }

        $now  = (new DateTimeImmutable())->format(DATE_RFC3339_EXTENDED);
        $ctx  = service('requestContext');      // 토큰에서 꺼낸 광고주·사용자
        $jobs = [];
        foreach ($events as $e) {
            $jobs[] = json_encode([
                'eid'         => (string) new Ulid(),
                'client_id'   => $ctx->clientId,
                'user_id'     => $ctx->userId,
                'event'       => (string) ($e['event'] ?? ''),
                'props'       => $e['props'] ?? [],
                'occurred_at' => (string) ($e['ts'] ?? $now),
                'received_at' => $now,
                'attempts'    => 0,
            ], JSON_UNESCAPED_UNICODE);
        }

        $queue->push($jobs);                    // LPUSH 한 번

        return $this->response->setStatusCode(202);
    }
}
여기서 정한 원칙은 "요청 안에서는 실패할 일이 적은 것만 한다" 입니다. 이벤트 이름이 사전에 있는지, props 구조가 맞는지 같은 깐깐한 검증은 워커로 넘겼습니다. 요청 안에서 거르면 그 로그는 응답 코드 하나로 사라지지만, 워커에서 거르면 dead-letter에 이유와 함께 남습니다.
eid를 서버에서 붙이는 이유는 뒤의 멱등 처리 때문입니다. 이 값이 DB의 UNIQUE 키가 되어, 같은 로그가 두 번 처리돼도 한 줄만 남습니다.
프론트 쪽: 모아서, 떠날 때도 보낸다
이벤트마다 요청을 보내지 않고, 메모리 버퍼에 모았다가 5초마다 또는 20개가 차면 한 번에 보냅니다. 페이지를 떠날 때는 남은 버퍼를 navigator.sendBeacon으로 보냅니다. 일반 fetch는 페이지가 닫히면서 취소될 수 있지만, beacon은 브라우저가 대신 끝까지 보내 줍니다.
const buf = [];
export function track(event, props = {}) {
  buf.push({ event, props, ts: new Date().toISOString() });
  if (buf.length >= 20) flush();
}
function flush(useBeacon = false) {
  if (!buf.length) return;
  const body = JSON.stringify({ events: buf.splice(0, 50) });
  if (useBeacon) {
    navigator.sendBeacon(`/api/v1/events?t=${beaconToken}`, new Blob([body], { type: 'application/json' }));
  } else {
    fetch('/api/v1/events', { method: 'POST', headers: authHeaders(), body, keepalive: true });
  }
}
setInterval(flush, 5000);
addEventListener('visibilitychange', () => document.visibilityState === 'hidden' && flush(true));
beacon은 Authorization 헤더를 붙일 수 없습니다. 그래서 beacon 전용으로 수명이 짧고 이 엔드포인트에만 쓰이는 토큰을 쿼리에 실어 보냅니다. unload 대신 visibilitychange를 쓰는 이유는 모바일 브라우저에서 unload가 아예 오지 않는 경우가 많기 때문입니다.
2단계 Redis 큐: 꺼낸 순간에도 잃어버리지 않기
큐에서 가장 위험한 순간은 넣을 때가 아니라 꺼낼 때입니다. RPOP으로 꺼낸 직후 워커가 죽으면, 그 로그는 Redis에도 없고 DB에도 없습니다.
그래서 꺼내는 동시에 처리 중 리스트로 옮깁니다. Redis 6.2부터 있는 BLMOVE는 한 리스트의 끝에서 꺼내 다른 리스트에 넣는 일을 원자적으로 합니다. 처리가 끝나야 처리 중 리스트에서 지웁니다.
|
키 |
역할 |
|---|---|
|
|
수집 API가 |
|
|
워커가 지금 처리 중인 배치. 워커마다 하나 |
|
|
재시도를 기다리는 항목. 점수 = 다시 시도할 시각인 ZSet |
|
|
끝내 처리하지 못한 항목과 실패 이유 |
// app/Libraries/EventQueue.php — 배치 꺼내기
public function claimBatch(string $workerId, int $max = 500, int $wait = 5): array
{
    $proc  = "log:processing:{$workerId}";
    $first = $this->redis->blmove('log:ingest', $proc, 'RIGHT', 'LEFT', $wait);
    if ($first === false) {
        return [];                          // 5초 동안 들어온 게 없음
    }

    $batch = [$first];
    while (count($batch) < $max) {
        $next = $this->redis->lmove('log:ingest', $proc, 'RIGHT', 'LEFT');
        if ($next === false) {
            break;
        }
        $batch[] = $next;
    }

    return $batch;
}

public function ack(string $workerId): void
{
    $this->redis->del("log:processing:{$workerId}");
}
첫 항목은 블로킹으로 기다리고, 나머지는 있는 만큼만 바로 가져옵니다. 한가할 때는 한 건씩 바로 처리되고, 몰릴 때는 500건씩 묶여서 처리됩니다. 지연과 처리량을 따로 조정하지 않아도 부하에 맞춰 배치 크기가 정해집니다.
워커가 죽었다 살아나면
워커 ID는 호스트 이름과 순번으로 고정합니다(web1-1, web1-2). 재시작한 워커는 일을 시작하기 전에 자기 처리 중 리스트에 남은 것을 대기열로 되돌립니다.
public function recover(string $workerId): int
{
    $proc = "log:processing:{$workerId}";
    $n    = 0;
    while ($this->redis->lmove($proc, 'log:ingest', 'LEFT', 'RIGHT') !== false) {
        $n++;
    }
    return $n;
}
이렇게 되돌린 항목은 이미 파일이나 DB에 일부 쓰였을 수 있습니다. 그래서 이 큐는 "정확히 한 번"이 아니라 "적어도 한 번" 전달을 보장하고, 중복은 다음 단계의 eid가 걸러 냅니다.
codeigniter4/queue 패키지도 검토했습니다. 웹훅 발송처럼 한 건 한 건이 의미 있는 작업에는 이 패키지가 맞습니다. 하지만 로그는 한 건씩 잡(job)으로 만들면 오버헤드가 내용보다 커서, 배치로 꺼내는 큐를 직접 짰습니다. phpredis의 blmove·lmove를 쓰므로 Redis 6.2 이상, phpredis 5.3.5 이상이 필요합니다.
3단계 워커: 파일에 먼저, DB에 다음
워커는 배치 하나를 받아 파일에 원본을 붙이고, DB에 넣고, ack 합니다. 이 순서에는 이유가 있습니다.
- 파일은 원본 보관소입니다. 하루 단위 JSONL 파일에 받은 그대로 한 줄씩 붙입니다. 집계 기준이 바뀌거나 DB를 다시 만들어야 할 때 이 파일을 다시 흘려 넣으면 됩니다. 처음 구조에 없던 "원본"이 여기서 생깁니다.
- DB는 조회용입니다. 대시보드와 집계는 DB를 봅니다. 그래서 DB에는 검증을 통과한 이벤트만 들어갑니다.
- 파일이 먼저인 이유는 쓰기가 실패할 가능성이 훨씬 낮기 때문입니다. DB 쓰기가 실패해도 원본은 이미 디스크에 있습니다.
// app/Commands/LogWork.php 의 처리 부분
private function process(array $batch): void
{
    // 1) 원본 보관 — 검증 전, 받은 그대로
    $path = WRITEPATH . 'events/' . date('Y-m-d') . '.jsonl';
    file_put_contents($path, implode("\n", $batch) . "\n", FILE_APPEND | LOCK_EX);

    // 2) 검증 — 형식이 틀린 항목은 재시도해도 소용없으니 바로 dead-letter
    $rows = [];
    foreach ($batch as $raw) {
        $e = json_decode($raw, true);
        $error = $this->validator->check($e);   // 이벤트 사전, props 스키마, 시각 범위
        if ($error !== null) {
            $this->queue->deadLetter($raw, 'invalid:' . $error);
            continue;
        }
        $rows[] = $this->mapper->toRow($e);
    }

    // 3) DB — eid UNIQUE + INSERT IGNORE 로 중복 무시
    if ($rows !== []) {
        $this->events->ignore(true)->insertBatch($rows);
    }
}
멱등: 두 번 처리돼도 한 줄
앞에서 "적어도 한 번"이라고 했으니 같은 배치가 두 번 들어오는 일은 실제로 생깁니다. DB는 eid에 걸린 UNIQUE 키와 INSERT IGNORE로 중복을 무시합니다.
CREATE TABLE app_events (
    id          BIGINT UNSIGNED AUTO_INCREMENT PRIMARY KEY,
    eid         CHAR(26)        NOT NULL,
    client_id   INT UNSIGNED    NOT NULL,     -- 광고주(병원)
    user_id     BIGINT UNSIGNED NULL,
    event       VARCHAR(50)     NOT NULL,
    props       JSON            NULL,
    occurred_at TIMESTAMP(3)    NOT NULL,
    received_at TIMESTAMP(3)    NOT NULL,
    UNIQUE KEY uk_eid (eid),
    KEY idx_client_time (client_id, occurred_at)
);
파일 쪽은 중복을 막지 않습니다. 같은 줄이 두 번 붙을 수 있다는 걸 받아들이고, 파일을 다시 흘려 넣을 때 eid로 거르기로 했습니다. 파일을 쓰기 전에 중복을 확인하려면 별도 저장소가 필요한데, 그 복잡도가 얻는 것보다 컸습니다.
IGNORE는 중복 키만이 아니라 일부 데이터 오류도 경고로 바꿔 삼킵니다. 그래서 형식 검증은 DB에 맡기지 않고 그 앞의 validator에서 끝냅니다. DB까지 온 행은 중복 말고는 실패할 이유가 없어야 합니다.
eid의 ULID는 symfony/uid의 Ulid를 씁니다. 시간순으로 정렬되는 값이라 UNIQUE 인덱스에 순서대로 쌓여, 무작위 UUID보다 인덱스 쓰기가 가볍습니다.
4단계 실패 처리: 재시도할 것과 dead-letter로 보낼 것
실패에는 두 종류가 있습니다. 기다리면 낫는 실패(DB 연결 끊김, 락 타임아웃, 디스크 일시 오류)와 몇 번을 해도 같은 실패(형식이 틀린 로그, 사전에 없는 이벤트)입니다. 둘을 같은 방식으로 다루면 전자는 버려지고 후자는 영원히 재시도됩니다.
|
실패 |
예 |
처리 |
|---|---|---|
|
검증 실패 |
JSON 깨짐, 모르는 이벤트, 미래 시각 |
재시도 없이 바로 dead-letter |
|
일시 장애 |
DB 연결 끊김, 락 타임아웃 |
지수 백오프로 최대 3회 재시도 |
|
배치 안의 독약 |
한 행 때문에 배치 전체 |
배치를 쪼개 한 건씩 넣고, 실패한 건만 dead-letter |
|
재시도 소진 |
3회 모두 실패 |
dead-letter |
재시도: 처리 중 리스트에서 빼서 ZSet으로
배치가 실패하면 그 항목들의 attempts를 올려 log:retry ZSet에 넣습니다. 점수는 다시 시도할 시각입니다. 10초, 60초, 300초로 늘려 가며, DB가 숨을 돌릴 시간을 줍니다. 워커는 배치를 꺼내기 전에 시각이 된 항목을 대기열로 옮깁니다.
private function handleFailure(array $batch, \Throwable $e): void
{
    // 배치가 2건 이상이면 먼저 쪼개서 범인을 찾는다
    if (count($batch) > 1 && $this->isDataError($e)) {
        foreach ($batch as $raw) {
            try {
                $this->process([$raw]);
            } catch (\Throwable $one) {
                $this->queue->deadLetter($raw, 'row:' . $one->getMessage());
            }
        }
        return;
    }

    foreach ($batch as $raw) {
        $job = json_decode($raw, true);
        $job['attempts']++;
        if ($job['attempts'] > 3) {
            $this->queue->deadLetter($raw, 'exhausted:' . $e->getMessage());
            continue;
        }
        $delay = [10, 60, 300][$job['attempts'] - 1];
        $this->queue->retryLater(json_encode($job, JSON_UNESCAPED_UNICODE), time() + $delay);
    }
}
실패 처리가 끝나면 원래 배치는 ack 합니다. 항목들은 이미 재시도 ZSet이나 dead-letter로 옮겨졌으니 처리 중 리스트에 남겨 둘 이유가 없습니다.
dead-letter에 남기는 것
dead-letter는 쓰레기통이 아니라 나중에 사람이 보는 받은편지함입니다. 그래서 원본만 넣지 않고 왜 여기 왔는지를 함께 남깁니다.
{
  "raw": "{\"eid\":\"01K82...\",\"event\":\"consult_reqest\", ...}",
  "reason": "invalid:unknown_event",
  "worker": "web1-2",
  "failed_at": "2026-10-20T14:02:11+09:00"
}
위 예처럼 앱 쪽 오타(consult_reqest)가 dead-letter에서 발견되는 일이 실제로 가장 흔했습니다. 처음 구조였다면 422 응답으로 끝났을 로그들이 여기서는 이유와 함께 쌓이니, 앱 배포 직후 dead-letter를 보는 것만으로 이벤트 이름 실수를 잡을 수 있었습니다.
다시 흘려 넣는 명령
원인을 고친 뒤에는 dead-letter를 다시 대기열로 보냅니다. 전부 한 번에 돌리지 않고 이유별로 고를 수 있게 했습니다.
php spark logs:dead list --reason=invalid:unknown_event --limit=20
php spark logs:dead replay --reason=exhausted        # DB 장애로 밀린 것만 재투입
php spark logs:dead purge --older-than=30dreplay는 attempts를 0으로 되돌려 대기열에 넣습니다. 이벤트 이름 오타처럼 데이터를 고쳐야 하는 경우는 --map=consult_reqest:consult_request 옵션으로 이름을 바꿔 넣습니다. 이렇게 재투입해도 eid가 그대로라, 혹시 이미 들어간 건이 있어도 중복되지 않습니다.
5단계 운영: 워커를 살려 두고, 큐를 지켜보기
systemd로 띄우고, 끌 때는 배치를 끝내고
워커는 php spark logs:work 명령이고, Ubuntu의 systemd 서비스로 띄웁니다. 템플릿 유닛 하나로 워커 수를 늘립니다.
# /etc/systemd/system/logworker@.service
[Unit]
Description=AICura log worker %i
After=redis-server.service mysql.service

[Service]
User=www-data
WorkingDirectory=/var/www/aicura
ExecStart=/usr/bin/php spark logs:work --id=%H-%i --max-batches=2000
Restart=always
RestartSec=3
KillSignal=SIGTERM
TimeoutStopSec=30

[Install]
WantedBy=multi-user.target
sudo systemctl enable --now logworker@1 logworker@2두 가지를 일부러 넣었습니다.
--max-batches=2000: 그만큼 처리하면 스스로 종료하고 systemd가 새로 띄웁니다. 오래 도는 PHP 프로세스의 메모리 누수를 신경 쓰지 않아도 되고, 배포 후 새 코드도 이 시점에 반영됩니다.- SIGTERM 처리:
pcntl_signal로 종료 신호를 받으면 플래그만 세우고, 지금 배치를 끝내고 ack 한 뒤 나갑니다. 배치 중간에 죽어도 2단계의 복구가 있지만, 정상 종료에서까지 복구에 기대면 중복이 늘어납니다.
배포 스크립트 마지막에는 systemctl restart 'logworker@*'를 넣었습니다. 워커는 웹 요청과 달리 OPcache 리로드로는 새 코드를 읽지 않기 때문입니다.
지켜보는 숫자는 세 개
|
지표 |
보는 법 |
경보 기준 |
|---|---|---|
|
대기열 길이 |
|
5분 넘게 10,000 이상 |
|
가장 오래된 항목의 나이 |
대기열 끝 항목의 |
2분 이상 |
|
dead-letter 증가 |
|
100건 이상 |
대기열 길이만 보면 "많지만 잘 빠지는" 상태와 "워커가 멈춘" 상태를 구분하기 어렵습니다. 가장 오래된 항목의 나이를 같이 보면 워커가 멈췄는지 바로 보입니다. 세 값은 /internal/health/queue 엔드포인트로 내보내고, 스케줄러가 1분마다 확인합니다.
백프레셔: 큐도 무한하지 않다
DB가 오래 멈추면 대기열이 끝없이 자라 Redis 메모리를 채웁니다. Redis가 가득 차면 수집뿐 아니라 같은 Redis를 쓰는 세션과 레이트 리밋까지 멈춥니다. 그래서 대기열이 상한(기본 200,000)을 넘으면 수집 API가 503과 Retry-After를 돌려줍니다. 프론트는 버퍼를 비우지 않고 다음 주기에 다시 보냅니다.
로그 몇 건을 잃는 것과 서비스 전체가 멈추는 것 중에서는 앞쪽을 고릅니다. 로그 파이프라인은 본 서비스를 지키는 쪽으로 실패해야 합니다.
파일 보존과 시간별 집계
- 파일:
writable/events/아래 날짜별 JSONL을 하루 지나면 gzip으로 압축하고, 180일 뒤 삭제합니다.logrotate가 아니라 스케줄러 태스크로 처리해 앱 설정 한곳에서 관리합니다. - 집계: 스케줄러가 매시 5분에 직전 1시간의
app_events를 광고주·이벤트별로 묶어app_event_hourly에 넣습니다. 대시보드는 원본 테이블이 아니라 이 집계 테이블을 봅니다. 늦게 도착한 로그를 위해 직전 3시간을 다시 계산합니다. - 개인정보:
props에는 식별 정보를 넣지 않는 것을 규칙으로 정했고, 워커의validator가 전화번호·이메일 형식의 값을 발견하면 dead-letter로 보냅니다. 파일에도 원본이 남기 때문에 이 검사는 파일에 쓰기 전에 하는 편이 맞는지 아직 고민하고 있습니다.
돌아보며
- 202는 약속의 크기를 줄이는 일이다. 요청 안에서 "저장까지 했다"를 약속하면 저장의 모든 실패가 응답 실패가 됩니다. "받았다"만 약속하니, 응답은 빨라지고 실패는 뒤에서 차분히 다룰 수 있게 됐습니다.
- 큐는 꺼낼 때 잃는다. 넣는 쪽보다 꺼내는 쪽에 공을 들여야 합니다.
BLMOVE와 처리 중 리스트, 시작할 때의 복구 세 가지가 "워커가 죽으면 로그도 죽는다"를 막았습니다. - "정확히 한 번"을 쫓지 말고 멱등을 만든다. 분산된 단계 사이에서 정확히 한 번을 보장하기는 어렵습니다. 대신
eid하나를 수집 시점에 붙여 두니, 재시도·복구·재투입이 모두 안전해졌습니다. - 실패를 분류하면 재시도가 정직해진다. 검증 실패를 재시도하면 시간만 쓰고, 일시 장애를 바로 버리면 데이터를 잃습니다. 둘을 나누고, 배치 안의 독약은 쪼개서 찾는 것까지가 실패 처리였습니다.
- dead-letter는 받은편지함이다. 실패 이유를 함께 남기자 dead-letter가 앱 쪽 버그를 알려 주는 창구가 됐습니다. 쌓아 두기만 하면 쓰레기통이고, 보고 다시 흘려 넣을 수 있어야 받은편지함입니다.
- 로그는 본 서비스를 위해 실패해야 한다. 백프레셔 503은 로그를 잃는 선택이지만, 서비스 전체를 지키는 선택이기도 합니다.
처음 만든다면 이 순서로
- 수집 API를 202 +
LPUSH로 바꾼다.eid는 이때부터 붙인다. - 워커를
BLMOVE+ 처리 중 리스트 + 시작 시 복구로 만든다. - DB에
eid UNIQUE를 걸고INSERT IGNORE로 넣는다. - 날짜별 JSONL 원본 파일을 붙인다.
- 실패를 분류하고 재시도 ZSet과 dead-letter를 만든다. 재투입 명령까지 만들어야 끝이다.
- 대기열 길이, 가장 오래된 항목의 나이, dead-letter 증가량에 경보를 건다.
1~3단계만으로도 처음 구조의 문제 대부분이 풀립니다. 4~6단계는 운영하면서 "그때 그 로그 어디 갔지?"라는 질문이 나오기 시작할 때 붙여도 늦지 않습니다.
댓글 0개