Claude Code 토큰 절감 실전: 3개월 로그 분석과 5단계 전략
시리즈 CLAUDE.md 규칙으로 보는 PHP 백엔드 기본기 현재 위치 15 / 15
- 직접 JWT 구현 금지! 검증된 라이브러리와 안전 설계
- CodeIgniter 4 + 모던 PHP 8.4: readonly DTO, backed enum, match로 배열·define() 걷어내기
- Redis 캐시 TTL 설계와 N+1 방지 실전 가이드
- CI4에서 얇은 컨트롤러와 서비스 기반 트랜잭션 관리법
- OpenAPI를 PHP 어트리뷰트로: $ref 재사용 컴포넌트와 공통 ErrorResponse
- DB는 UTC, 화면은 KST: TIMESTAMP + 세션 타임존으로 변환 코드 없애기
- 프론트 로그를 큐로 받는 수집 파이프라인: 즉시 202 → Redis → 워커 → 파일 + DB, 실패 시 dead-letter
- 서비스를 쪼갤까? MSA 선택을 위한 실전 체크리스트
- MSA 공통 에러 규약, RFC 9457로 정하기
- 스쿼시 머지 vs 머지 커밋: 1인 개발자의 PR 전략
- "난이도가 높아서 오래 걸리는 거야?" — AIFid 개발 기록으로 따져 본 소요 시간
- CLAUDE.md로 팀 규칙을 AI에게 가르치는 법
- CI4 브랜드 에러 페이지: 설계서 한 장에서 구현까지
- 870줄 CLAUDE.md를 116줄로 줄인 실전 리팩터링
- Claude Code 토큰 절감 실전: 3개월 로그 분석과 5단계 전략
시리즈 Claude Code 워크플로 현재 위치 25 / 29
- git worktree로 AI 세션 여러 개를 동시에 돌리기: 브랜치 충돌과 stash 공유 사고를 피하는 운영 규칙
- AI에게 기억을 심는 법: 메모리 파일로 삽질 교훈을 세션 간에 유지하기
- 스킬로 반복 작업 자동화: 이슈 착수부터 종료까지 한 명령으로 묶은 dev-issue 사례
- 코드 그래프(graft)로 AI의 탐색 비용 줄이기: grep/read 대비 토큰 절감 체감
- AI 코드 리뷰를 규칙으로 고정하기
- 반복되는 Git 워크플로우와 브랜치 정리 자동화
- 같은 요청을 여러 저장소에 반복하는 법: 한 줄 프롬프트 + 기준 문서 하나
- 이슈 하나를 한 줄로 개발 끝내는 법 — 내가 가장 많이 쓰는 Claude Code 스킬들
- 블로그 글을 스무 번 부탁하고 나서, 스킬로 만들었다
- 마라톤 세션이 토큰을 먹는 구조: 로그로 찾고, /compact와 서브에이전트로 줄이기
- 1인 개발자가 클로드코드로 SaaS 11개 만든 기록
- 이슈 하나에 30~60분, 어디서 새고 있었나: skill-creator로 dev-issue 스킬을 만든 과정
- 도면을 AI에게 읽히려다 AI를 뺀 이야기
- 스쿼시 머지 vs 머지 커밋: 1인 개발자의 PR 전략
- "난이도가 높아서 오래 걸리는 거야?" — AIFid 개발 기록으로 따져 본 소요 시간
- 엑셀 간편장부를 웹 ERP로 옮기기 (AICassa)
- Impeccable 스킬 적용한 게시글 상세 화면 구조 개선
- CLAUDE.md로 팀 규칙을 AI에게 가르치는 법
- AI티 나는 디자인 패턴 걷어내기: overused-font 훅 오탐 처리와 접근성 대비 수정
- CI4 브랜드 에러 페이지: 설계서 한 장에서 구현까지
- Claude에 MCP로 디자인 툴 붙이기 — DesignCraft·PhotoCraft 설치부터 명함, 카툰 효과까지
- AI 실수 복구: 메인 체크아웃을 dev 상태로 되돌린 기록
- 870줄 CLAUDE.md를 116줄로 줄인 실전 리팩터링
- AI로 AI 강의안을 만들다 — 실용인문학 5·6강 준비기
- Claude Code 토큰 절감 실전: 3개월 로그 분석과 5단계 전략
- 개발 기록을 재료로 AI가 쓰는 블로그 글 만들기
- Claude Vision으로 영수증·세금계산서 자동 장부 입력 구현
- AI가 만든 실제 실수 4가지 패턴과 교훈
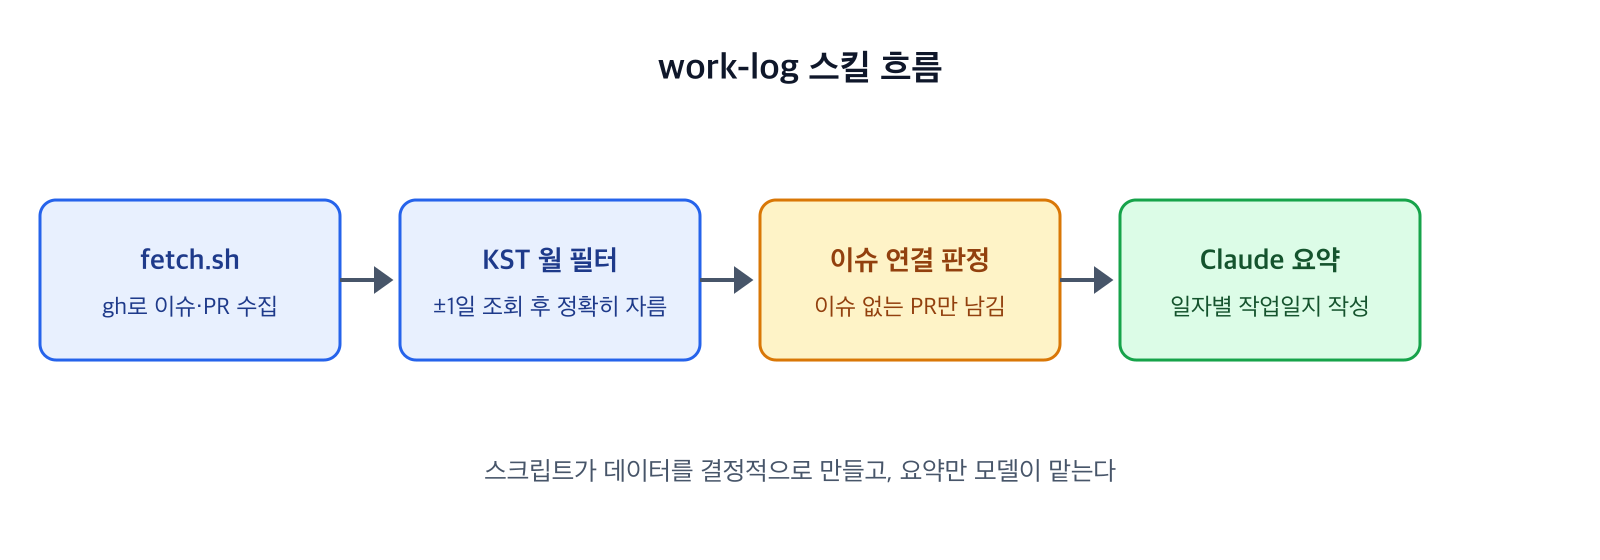
- GitHub 이슈·PR 기반의 월간 작업일지 자동 생성 Claude 스킬 만들기
7월부터 10월까지 Claude Code로 PHP/CodeIgniter 4 프로젝트 여러 개를 돌리면서 토큰이 눈에 띄게 불어났다. 감으로 아끼려 하지 않고 세션 로그부터 집계해서 원인을 찾았고, 그 뒤로 시도한 것들과 실제로 효과가 있었던 것, 없었던 것을 정리한다.
1. 계기: "토큰이 왜 이렇게 늘었지?"
8월 24일, Claude Code에 이렇게 물었다.
토큰 사용량이 많이 늘었는데 각 디렉토리 로그 확인해서 분석해주고 토큰 사용량 줄일 수 있는 방법 알려줘
Claude Code는 ~/.claude/projects/ 아래에 세션마다 .jsonl 로그를 남긴다. 메시지마다 usage(입력·출력·캐시 읽기 토큰)가 들어 있어서, 이걸 합치면 어느 프로젝트와 어느 세션이 토큰을 먹는지 바로 나온다. 당시 98개 프로젝트 디렉토리를 훑은 결과는 의외였다.
- 누적 토큰의 **약 99%가
cache_read**였다. 프롬프트 캐싱은 멀쩡히 동작하고 있었다. 문제는 캐시가 안 되는 게 아니라, 매 턴 읽어야 하는 컨텍스트 자체가 너무 크고 너무 오래 유지된다는 점이었다. - 사용량은 "평소 작업이 조금씩 늘어서"가 아니라 초장기 세션 몇 개가 만들었다. 한 세션은 약 27시간 동안 2,700여 턴을 이어가며 최대 컨텍스트가 99만 토큰까지 커졌고, 그 프로젝트 전체 사용량의 18%를 혼자 차지했다. 상위 5개 세션이 60% 이상이었다.
- 거대한 tool 결과 118건을 뽑아보니 거의 전부 브라우저 스크린샷(건당 2~3만 토큰)이었다. 한 번 찍은 이미지는 컨텍스트에서 빠지지 않고, 이후 모든 턴마다 다시 전송된다.
- 부수 원인으로
ScheduleWakeup//loop자동 워크플로가 끊기지 않고 수십 시간 돌았고, 다 쓴 워크트리 수십 개가 방치돼 로그와 디스크가 쌓였다.
정리하면 토큰 = 턴 수 × 컨텍스트 크기다. 캐시 덕에 단가는 싸지만 곱셈 자체는 그대로 커진다. 줄이려면 곱하는 두 숫자 중 하나를 건드려야 한다.
2. 1단계: 습관을 문서로 박제 (8/24)
분석 직후 "절감방법을 최상위 클로드문서에 넣어줘"라고 해서 전역 ~/.claude/CLAUDE.md에 "세션·토큰 사용량 관리" 섹션을 추가했다. 전역 문서라 모든 프로젝트에 자동 적용된다. 내용은 여섯 가지다.
- 작업 단위가 끝나면 새 세션을 열거나
/compact로 정리한다. 턴 수가 누적 토큰을 좌우한다. - 자동 루프는 2~4시간마다 세션을 리셋한다. 24시간 넘는 단일 세션은 금지.
- 스크린샷은 확인이 끝나면 컨텍스트에 남기지 않는다. 전체 캡처 대신
zoom으로 바뀐 영역만 찍고, 반복적인 UI 확인·클릭 루프는 서브에이전트에 위임한다. - 같은 탐색(
ls/grep/find)이 3번 넘게 반복되면 Explore 서브에이전트에 넘긴다. 파일이 수천 개인 디렉토리는 쿼리 범위를 좁힌다. - 끝난 워크트리와 브랜치는 바로 정리한다(
prune-branch스킬). 이날 워크트리 12개와 원격 브랜치 4개를 실제로 치웠다. - 사용량이 평소보다 튀면
~/.claude/projects/로그부터 확인한다.
규칙을 문서로 남긴 이유는 단순하다. 나는 어제의 결심을 오늘 잊는다. 세션이 시작될 때 자동으로 로드되는 문서에 적어두면 Claude가 대신 기억해 준다.
3. 2단계: 읽을 필요 없는 걸 못 읽게 막기 (9/9)
두 번째는 컨텍스트에 들어가는 입력을 줄이는 쪽이다. settings.json의 permissions.deny에 node_modules, dist, .git 하위 경로의 Read를 막았다.
"permissions": { "deny": [ "Read(**/node_modules/**)", "Read(**/dist/**)", "Read(**/.git/**)" ] }
Claude가 빌드 산출물이나 의존성 폴더의 파일을 통째로 읽어 컨텍스트를 낭비하는 일을 원천 차단한다. 한 번 설정하면 신경 쓸 일이 없다는 점이 가장 큰 장점이다.
(덧붙임: 나중에 설정 파일을 다시 열어보니 같은 규칙이 세 번씩 중복 기록돼 있었고, 막은 건 Read뿐이었다. Grep/Glob까지 막았다고 생각했는데 실제로는 아니었다. 설정을 바꾼 뒤에는 결과 파일을 직접 열어 확인하는 편이 안전하다.)
4. 3단계: 코드 탐색을 도구로 대체 — graft (8/25~)
토큰의 상당 부분은 결국 "코드를 찾느라 읽는 파일들"이다. 이슈 하나를 시작할 때마다 grep → cat → sed를 수십 번 반복하면 그 출력이 전부 컨텍스트에 쌓인다.
그래서 graft를 도입했다. 저장소의 모든 심볼과 호출 관계를 미리 그래프로 만들어 두고, "X는 어디 있나", "Y를 누가 부르나", "이 파일의 API가 뭔가"를 한 번의 호출로 답하게 하는 도구다. 처음 켰을 때 저장소 하나는 파일 671개, 심볼 5,308개, 엣지 9,682개로 인덱싱됐고, graft는 응답에 이런 한 줄을 붙였다.
graft saved ~694,538 tokens this turn.
다만 이 숫자는 graft가 스스로 계산한 추정치이고, 내가 독립적으로 검증한 값은 아니다. 그래도 방향은 분명하다. 파일을 줄줄이 읽는 대신 필요한 심볼과 호출 관계만 받아오면 컨텍스트가 훨씬 작아진다. 이후 /dev-issue, /start-issue 스킬이 탐색 단계에서 graft를 먼저 쓰도록 연결했다.
5. 4단계: 말수를 줄이기 — caveman (8/25~)
출력 토큰도 줄이고 싶어서 같은 날 caveman 플러그인을 설치했다. 인사말, 군더더기, 반복 요약을 걷어내고 기술 용어와 코드는 그대로 두는 간결 응답 모드다. 코드 블록, 커밋 메시지, 문서처럼 다른 사람이 읽는 글은 정상 문장으로 쓰도록 예외를 둔다. 긴 세션에서 답변이 점점 장황해지는 현상을 눌러 주는 효과가 있다.
6. 5단계: 약속은 안 지켜진다, 그래서 훅으로 강제 (10월)
여기서부터가 이 글에서 가장 솔직하게 적고 싶은 부분이다.
graft와 caveman을 도입했는데도 Claude가 자꾸 쓰지 않았다. 내 기록에는 이런 메시지가 줄줄이 남아 있다.
- "graft 사용했냐고?"
- "caveman 안써?" → "caveman 진짜 안쓸꺼야?" → "caveman 안쓰냐? 어제부터 몇번째야?"
한 프로젝트의 메모리에는 같은 위반이 세 번 기록됐다. 메모리 파일과 시작 시 안내가 컨텍스트에 분명히 있었는데도, "읽을 파일이 이미 정해져 있다"는 이유로 습관적으로 ls/grep/cat부터 잡았다. 세 번째에는 "다음부터 쓰겠다"고 말로 약속까지 했지만 또 어겼다. 그때 메모리에 적힌 결론은 이렇다.
메모리만으로는 재발이 막히지 않았다는 증거라 훅 같은 기계적 강제가 필요하다.
그래서 PreToolUse(Bash) 훅을 만들었다. 해당 저장소에서 세션 안에 graft 호출 이력이 없는 상태로 grep/cat/sed/ls/find 같은 탐색 명령을 내리면, 훅이 exit 2와 함께 "graft를 먼저 호출하라"는 메시지를 돌려주며 차단한다. 트랜스크립트에서 mcp__graft__ 또는 graft ask|grep|skeleton|callers 호출 이력을 찾는 방식이라, 한 번 호출하고 나면 그 뒤로는 자유롭게 쓸 수 있다.
교훈은 두 가지다.
- "기억해 둬"는 규칙이 아니다. 모델에게 부탁하는 규칙은 확률적이고, 확률은 언젠가 빗나간다. 반드시 지켜져야 하는 절약 습관이라면 훅이나 deny 규칙처럼 도구 수준에서 강제한다.
- 반대로 메모리와 CLAUDE.md는 "왜 그렇게 하는지"를 전달하는 데 좋다. 강제는 훅이, 맥락은 문서가 맡는 식으로 역할을 나눴다.
7. 그 밖에 효과를 본 것들
- 작업 흐름 표준화:
dev-issue스킬에 "구현 전에 탐색부터 위임한다 / 푸시 전에 전체 검증을 통과시킨다"를 못 박았다. 실측해 보니 시간(과 토큰)을 가장 많이 새게 한 건 코딩이 아니라 불확실성(무엇을 어디에 손댈지 모른 채 시작)과 CI 재실패 왕복이었다. 이미 구현된 이슈를 다시 구현하는 낭비만 막아도 30~60분이 절약된다. - CI 왕복 줄이기:
pre-push훅에서composer check를 돌려 실패를 로컬에서 먼저 잡는다.push → CI 실패 → 재커밋한 바퀴마다 컨텍스트에는 로그가 한 덩어리씩 쌓인다. - 서브에이전트 위임: 구현 계획을 태스크 단위로 쪼개서 서브에이전트가 각자 깨끗한 컨텍스트에서 처리하게 했다. 메인 세션에는 결과 요약만 돌아온다.
- 지연 로딩 도구:
ENABLE_TOOL_SEARCH=auto로 두면 수백 개 MCP 도구의 스키마를 처음부터 다 싣지 않고 필요할 때만 불러온다. - 워크트리 즉시 정리: 머지가 끝나면 워크트리와 브랜치를 바로 치운다.
8. 결과: 숫자로 보면
세션 로그를 중복 제거해서 주 단위로 다시 집계했다. (아래 숫자는 같은 요청 ID를 한 번만 센 값이라, 8/24에 처음 집계한 총량과는 다르다. 대신 두 시기를 같은 기준으로 비교할 수 있다.)
| 구간 | 주당 cache_read | 턴당 평균 읽기 | 주당 세션 수 |
|---|---|---|---|
| 7월 말8월 중순 (W30W33) | 1.2~2.5B | 약 220~395k | 13~55 |
| 10월 (W40~W43) | 0.14~0.33B | 약 100~145k | 121~138 |
- 턴당 평균 컨텍스트가 약 30만 → 10만 토큰대로 내려갔다. 곱셈의 한쪽 숫자가 실제로 줄었다는 뜻이다.
- 세션은 훨씬 잘게 쪼개졌다. 주당 세션 수가 13~55개에서 120개 이상으로 늘었고, 길게 이어지던 마라톤 세션이 사라졌다.
- 주당 총 cache_read도 W30~W33 평균 약 1.8B에서 10월 평균 약 0.25B 수준으로 내려왔다.
주의할 점도 있다. 이 비교는 엄밀한 통제 실험이 아니다. 10월은 이슈의 크기, 작업량, 프로젝트 구성이 7~8월과 다르고, W43은 아직 진행 중인 주다. 그래서 총량 감소의 몇 퍼센트가 어떤 대책 덕분인지는 나눠서 말할 수 없다. graft의 절감 토큰도 추정치다. 확실히 말할 수 있는 건 "마라톤 세션이 사라졌고 턴당 컨텍스트가 줄었다"는 정도다.
9월 30일에는 한 프로젝트에서 사용량 한도에 도달해 작업이 끊기기도 했다. 아직 갈 길이 남았다는 신호로 받아들인다.
9. 정리: 나라면 이 순서로 한다
- 먼저 측정한다.
~/.claude/projects/*.jsonl의usage를 합산하는 스크립트 하나면 충분하다. 어디가 새는지 모르고 아끼면 엉뚱한 곳만 조인다. - 세션을 끊는다. 가장 큰 레버다. 작업 단위가 끝나면 새 세션, 자동 루프는 몇 시간 단위로 리셋.
- 스크린샷은 영역을 좁히고 위임한다. 이미지 한 장이 이후 모든 턴에 따라붙는다.
- 읽지 않아도 되는 건 deny로 막는다.
node_modules,dist,.git. - 탐색은 도구에 맡긴다. 코드 그래프(graft 같은 것)와 서브에이전트.
- 중요한 습관은 훅으로 강제한다. 부탁은 지켜지지 않는다.
- 설정은 적용 후 직접 열어서 확인한다. 나처럼 같은 규칙을 세 번 쓰고도 모르고 지나가지 않도록.
토큰 절약은 한 방에 끝나는 일이 아니라, 측정 → 규칙화 → 강제의 반복이었다. 다음 목표는 주간 집계 스크립트를 자동으로 돌려서, 튀는 주가 생기면 바로 알려주게 만드는 것이다.
댓글 1
하네스가 괜히 있는거 아니네.
좋은 글 감사