정규식 기반 마크다운 렌더러 구현기와 보안 고찰
시리즈 블로그 기능 추가 현재 위치 9 / 14
- 블로그 기능을 하나씩 직접 만들기 ① 시리즈 내비게이션
- 블로그 글 목차(TOC)를 JS 70줄로 직접 만들기
- 블로그 기능을 하나씩 직접 만들기 3 — CodeIgniter 4로 RSS 피드 만들기
- 글마다 다른 OG 썸네일을 GD로 자동 생성하기 (CodeIgniter 4)
- 스캐너 IP 자동 차단: 404 3회 일배치와 즉시 차단, 오차단 방어까지
- 워드프레스 이관 후 깨진 이미지, 태그째 정리하기 (CodeIgniter 4)
- Groq로 글 태그·시리즈 자동 추천: 환각 필터와 호출 제한
- CodeIgniter 4 테마 폴백으로 애드센스 자동 삽입하기
- 정규식 기반 마크다운 렌더러 구현기와 보안 고찰
- 블로그 개선 10개를 이슈로 쪼개 병렬로 만들며 배운 것
- Impeccable 스킬 적용한 게시글 상세 화면 구조 개선
- CMS 에디터가 내 CSS를 지웠다 — 소개 페이지 삽질기
- 하루 만에 구현한 9가지 블로그 운영 기능과 설계 기준
- 코어를 건드리지않고 확장하는 CodeIgniter 4 플러그인 구조와 핵심 설계 포인트
요약: 글을 Claude로 쓰다 보니 마크다운이 그대로 저장돼 화면에
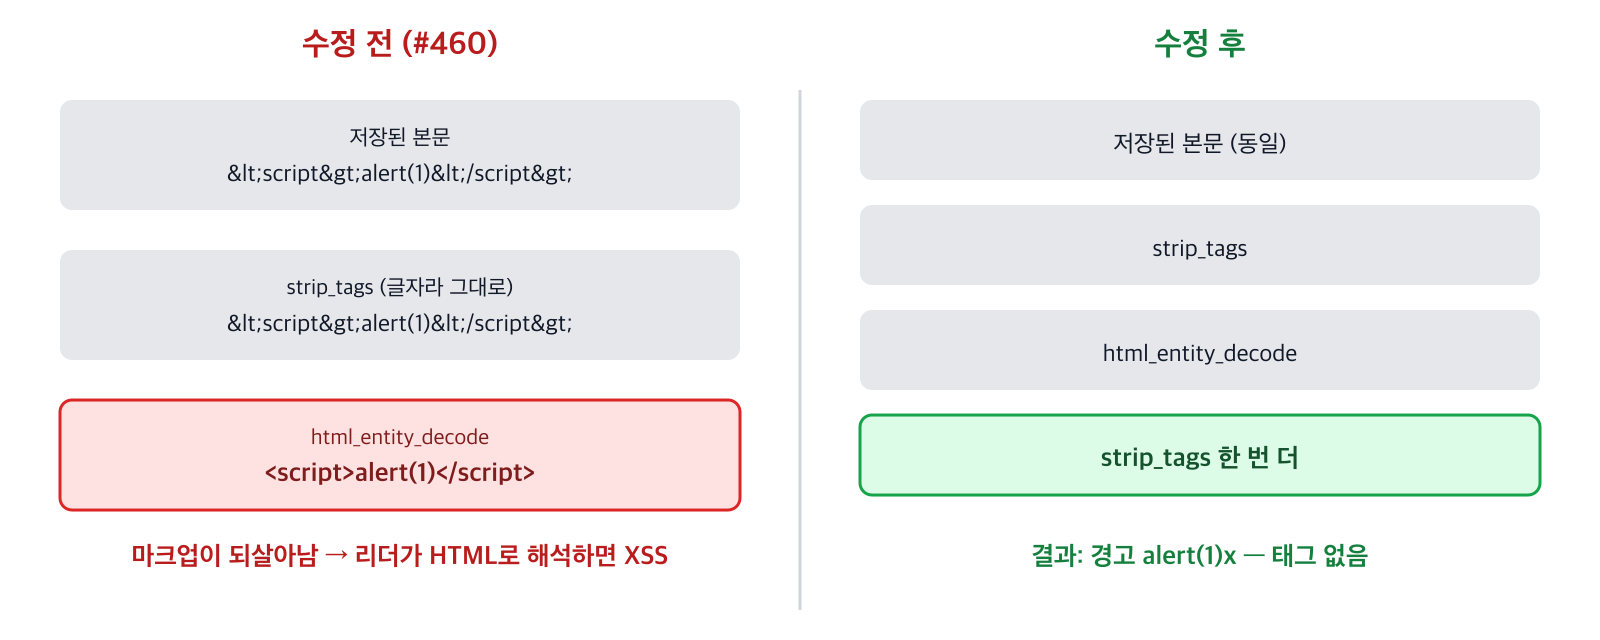
**와##가 노출됐다. 마크다운 라이브러리 대신 정화된 HTML 위에서 굵게 → 제목 → 목록·인용 → 코드 블록·표 순으로 정규식 치환기를 쌓았다. 같은 시기 요약문 함수에서<script>가 엔티티 해제 후 태그로 되살아나는 XSS(#460)도 잡았다. 정화는 마지막 디코딩 뒤에 해야 한다.
문제: 저장된 글에 마크다운이 그대로 보인다
블로그 글을 Claude로 쓰다 보니 본문이 마크다운이다. 그런데 편집기는 TinyMCE라서 붙여넣으면
**굵게**
,
제목
같은 문단으로 저장된다. 상세 화면에는 별표와 샵이 그대로 나왔다. 처음 이슈(#472)는 한 줄이었다.
굵은 글자(
**90분짜리 「AI 여행강의」 PPT(17장)**)가 치환이 안 된다.
이어서 "상세보기에 md 렌더링 추가"(#477), "코드 블록·표"(#480)로 요구가 늘었다. 처음엔 굵게 하나만 고칠 생각이었는데, 결국 렌더러가 됐다.
방침: 저장은 건드리지 않고, 정화된 HTML을 출력 직전에 치환한다
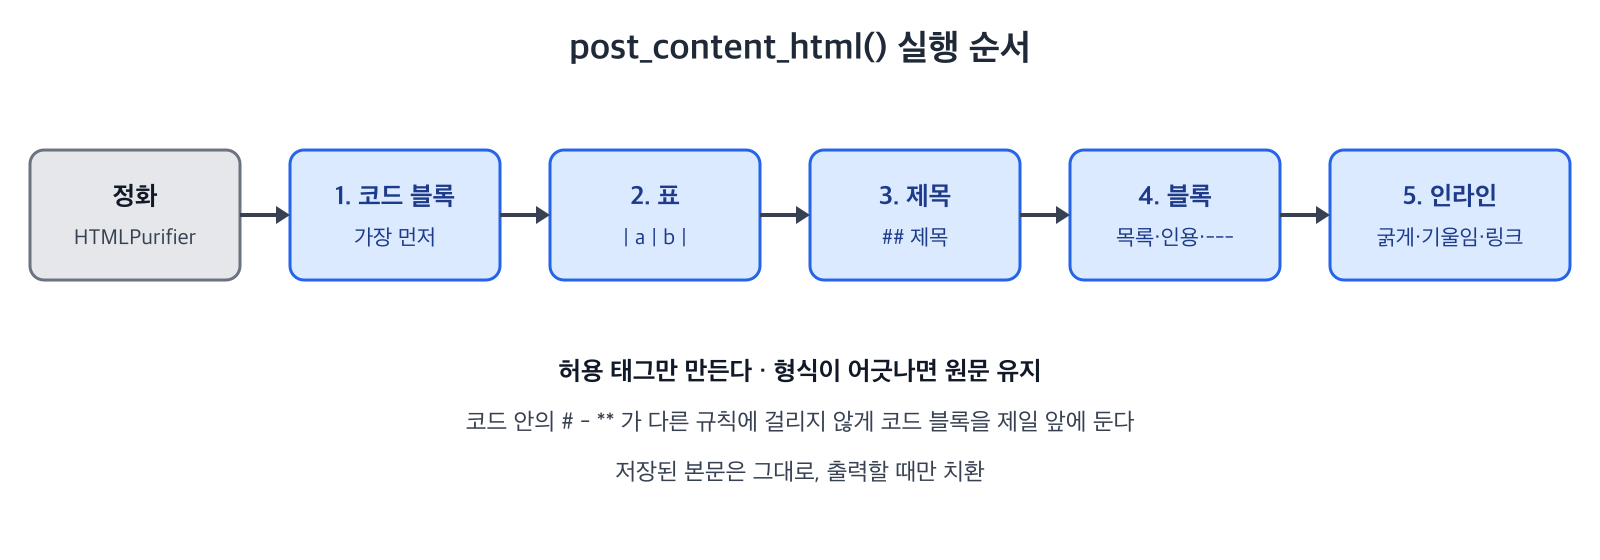
마크다운 라이브러리를 쓰지 않았다. 이유는 입력이 마크다운 원문이 아니라 이미 HTML이기 때문이다. 이미 HtmlSanitizer::clean()(HTMLPurifier 허용목록, #429)을 통과한
…
문단 안에 마크다운 기호가 글자로 남아 있다. 여기서 라이브러리에 원문을 다시 넘기려면 HTML을 마크다운으로 되돌려야 한다.
대신 규칙을 세 가지로 잡았다.
- 정화가 먼저, 치환이 나중. 치환기가 만들 수 있는 태그는
strong,em,code,h1~h6,ul/ol/li,blockquote,hr,pre,table,a뿐이다. - 애매하면 원문 유지. 형식이 한 줄이라도 어긋나면 변환하지 않는다. 글이 사라지는 것보다
**가 보이는 편이 낫다. - 저장된 본문은 그대로 둔다.
post_content_html()이 출력할 때만 바꾼다. 규칙을 고치면 옛 글에도 바로 적용된다.
1단계: 굵게 — 태그 사이의 글자만 건드린다
가장 먼저 만든 것은 굵게다. 핵심은 HTML을 <...> 기준으로 쪼개 텍스트 조각에만 정규식을 돌리는 것이다. 그래야 같은 속성 안을 건드리지 않는다. pre·code 안도 건너뛴다.
$parts = preg_split('/(<[^>]*>)/', $html, -1, PREG_SPLIT_DELIM_CAPTURE);
$codeDepth = 0;

foreach ($parts as $i => $part) {
    if (preg_match('~^<(/?)(?:pre|code)[\s>]~i', $part, $m) === 1) {
        $codeDepth += $m[1] === '/' ? -1 : 1;
    } elseif ($codeDepth <= 0 && ($part === '' || $part[0] !== '<')) {
        $parts[$i] = preg_replace('/\*\*(?=\S)(.+?)(?<=\S)\*\*/u', '$1', $part);
    }
}
첫 버전은 이틀도 못 갔다. 두 가지를 바로 고쳤다(79f8347).
.+?는 별표를 가로질러 **a** 그리고 **b** 같은 경계에서 엉뚱하게 묶일 수 있다. 내부를 [^*]+?로 바꿨다.
정규식이 PCRE 한도를 넘으면 preg_replace가 null을 돌려준다. 그대로 대입하면 문단이 통째로 지워진다. null이면 원문을 유지한다.
// PCRE 한도 초과로 null 이 오면 원문을 그대로 둔다 (본문이 지워지지 않게)
$replaced = str_contains($part, '**')
    ? preg_replace('/\*\*(?=\S)([^*]+?)(?<=\S)\*\*/u', '$1', $part)
    : null;
if ($replaced !== null) {
    $parts[$i] = $replaced;
}
2단계: 제목 — 문단 전체가 제목 한 줄일 때만
로 바꾼다. 문장 중간의 #이나 코드 안의 # 주석은 문단 전체가 아니므로 걸리지 않는다.
'~\s*(#{1,6})\s+([^<\s][^<]*?)\s*
~u'3단계: 목록·인용·구분선 — 모든 줄이 맞아야 한다
foreach (['ul' => '/^[-*+]\s+(\S.*)$/su', 'ol' => '/^\d{1,3}[.)]\s+(\S.*)$/su'] as $tag => $pattern) {
    $items = post_markdown_strip_lines($lines, $pattern);
    if ($items !== null) {
        return "<{$tag}>" . implode('', $items) . "";
    }
} 경계를 지워 하나로 합친다. 인용은 >가 정화 과정에서 >로 바뀌어 있을 수 있어 둘 다 받는다.
인라인(` 코드 , *기울임*, 글)은 이때 굵게와 한 함수로 합쳤다. 링크가 가장 조심스러웠다. 주소는 https?:// 또는 /로 시작하는 것만 허용한다. javascript: 같은 스킴은 패턴에 맞지 않아 변환 자체가 안 된다. a` 안은 다시 변환하지 않는다.
4단계: 코드 블록 — 가장 먼저 실행해야 한다
코드 블록은 쌓은 순서로는 마지막인데, 실행 순서로는 제일 앞이다. 코드 안의 #, -, **가 제목·목록·굵게 규칙에 걸리면 안 되기 때문이다.
post_markdown_inline(
    post_markdown_blocks(
        post_markdown_headings(
            post_markdown_tables(
                post_markdown_fences(HtmlSanitizer::clean($html))))))
여는 ``` ` 는 문단 시작에, 닫는 ` 는 문단 끝에 있어야 하고, 여러
에 걸쳐도 된다. 언어(bash)는 class="language-bash"로 남긴다. 변환 뒤 내용은 strip_tags만 하고 **엔티티는 풀지 않는다.** 코드 안 <b>는 <b> 그대로 pre`에 들어간다. 이 선택이 뒤의 보안 이야기와 이어진다.
5단계: 표 — 파이프가 태그 속성에도 있다
표는 |로 시작·끝나는 줄 뒤에 |---|---| 구분 줄이 올 때만 로 바꾼다. 첫 줄은
댓글 0
아직 댓글이 없습니다. 첫 댓글을 남겨 보세요.