요약: 글을 Claude로 쓰다 보니 마크다운이 그대로 저장돼 화면에
**와##가 노출됐다. 마크다운 라이브러리 대신 정화된 HTML 위에서 굵게 → 제목 → 목록·인용 → 코드 블록·표 순으로 정규식 치환기를 쌓았다. 같은 시기 요약문 함수에서<script>가 엔티티 해제 후 태그로 되살아나는 XSS(#460)도 잡았다. 정화는 마지막 디코딩 뒤에 해야 한다.
문제: 저장된 글에 마크다운이 그대로 보인다
블로그 글을 Claude로 쓰다 보니 본문이 마크다운이다. 그런데 편집기는 TinyMCE라서 붙여넣으면 <p>**굵게**</p>, <p>## 제목</p> 같은 문단으로 저장된다. 상세 화면에는 별표와 샵이 그대로 나왔다. 처음 이슈(#472)는 한 줄이었다.
굵은 글자(
**90분짜리 「AI 여행강의」 PPT(17장)**)가 치환이 안 된다.
이어서 "상세보기에 md 렌더링 추가"(#477), "코드 블록·표"(#480)로 요구가 늘었다. 처음엔 굵게 하나만 고칠 생각이었는데, 결국 렌더러가 됐다.
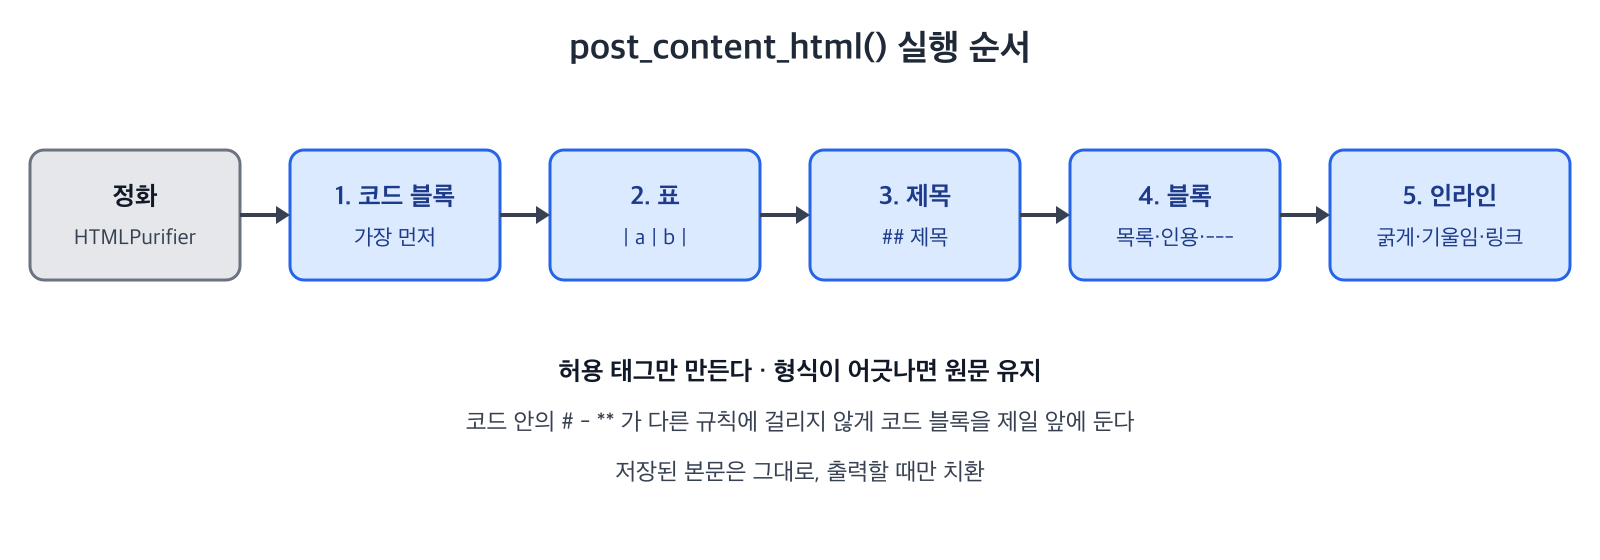
방침: 저장은 건드리지 않고, 정화된 HTML을 출력 직전에 치환한다
마크다운 라이브러리를 쓰지 않았다. 이유는 입력이 마크다운 원문이 아니라 이미 HTML이기 때문이다. 이미 HtmlSanitizer::clean()(HTMLPurifier 허용목록, #429)을 통과한 <p>…</p> 문단 안에 마크다운 기호가 글자로 남아 있다. 여기서 라이브러리에 원문을 다시 넘기려면 HTML을 마크다운으로 되돌려야 한다.
대신 규칙을 세 가지로 잡았다.
- 정화가 먼저, 치환이 나중. 치환기가 만들 수 있는 태그는
strong,em,code,h1~h6,ul/ol/li,blockquote,hr,pre,table,a뿐이다. - 애매하면 원문 유지. 형식이 한 줄이라도 어긋나면 변환하지 않는다. 글이 사라지는 것보다
**가 보이는 편이 낫다. - 저장된 본문은 그대로 둔다.
post_content_html()이 출력할 때만 바꾼다. 규칙을 고치면 옛 글에도 바로 적용된다.
1단계: 굵게 — 태그 사이의 글자만 건드린다
가장 먼저 만든 것은 굵게다. 핵심은 HTML을 <...> 기준으로 쪼개 텍스트 조각에만 정규식을 돌리는 것이다. 그래야 <a title="**x**"> 같은 속성 안을 건드리지 않는다. pre·code 안도 건너뛴다.
$parts = preg_split('/(<[^>]*>)/', $html, -1, PREG_SPLIT_DELIM_CAPTURE);
$codeDepth = 0;

foreach ($parts as $i => $part) {
    if (preg_match('~^<(/?)(?:pre|code)[\s>]~i', $part, $m) === 1) {
        $codeDepth += $m[1] === '/' ? -1 : 1;
    } elseif ($codeDepth <= 0 && ($part === '' || $part[0] !== '<')) {
        $parts[$i] = preg_replace('/\*\*(?=\S)(.+?)(?<=\S)\*\*/u', '<strong>$1</strong>', $part);
    }
}
첫 버전은 이틀도 못 갔다. 두 가지를 바로 고쳤다(79f8347).
.+?는 별표를 가로질러**a** 그리고 **b**같은 경계에서 엉뚱하게 묶일 수 있다. 내부를[^*]+?로 바꿨다.- 정규식이 PCRE 한도를 넘으면
preg_replace가null을 돌려준다. 그대로 대입하면 문단이 통째로 지워진다.null이면 원문을 유지한다.
// PCRE 한도 초과로 null 이 오면 원문을 그대로 둔다 (본문이 지워지지 않게)
$replaced = str_contains($part, '**')
    ? preg_replace('/\*\*(?=\S)([^*]+?)(?<=\S)\*\*/u', '<strong>$1</strong>', $part)
    : null;
if ($replaced !== null) {
    $parts[$i] = $replaced;
}
2단계: 제목 — 문단 전체가 제목 한 줄일 때만
## 제목은 <p> 하나가 통째로 그 한 줄일 때만 <h2>로 바꾼다. 문장 중간의 #이나 코드 안의 # 주석은 문단 전체가 아니므로 걸리지 않는다.
'~<p>\s*(#{1,6})\s+([^<\s][^<]*?)\s*</p>~u'3단계: 목록·인용·구분선 — 모든 줄이 맞아야 한다
TinyMCE는 엔터 한 번이면 <p>를, 시프트 엔터면 <br>을 만든다. 같은 목록도 문단 하나에 <br>로 이어지기도, 문단마다 나뉘기도 한다. 그래서 문단 안을 <br> 기준으로 줄로 쪼갠 뒤, 모든 줄이 같은 패턴에 맞을 때만 변환한다.
foreach (['ul' => '/^[-*+]\s+(\S.*)$/su', 'ol' => '/^\d{1,3}[.)]\s+(\S.*)$/su'] as $tag => $pattern) {
    $items = post_markdown_strip_lines($lines, $pattern);
    if ($items !== null) {
        return "<{$tag}><li>" . implode('</li><li>', $items) . "</li></{$tag}>";
    }
}
문단마다 <ul>이 하나씩 생기므로 마지막에 </ul><ul> 경계를 지워 하나로 합친다. 인용은 >가 정화 과정에서 >로 바뀌어 있을 수 있어 둘 다 받는다.
인라인(` 코드 , 기울임, 글)은 이때 굵게와 한 함수로 합쳤다. 링크가 가장 조심스러웠다. 주소는 https?:// 또는 /로 시작하는 것만 허용한다. javascript: 같은 스킴은 패턴에 맞지 않아 변환 자체가 안 된다. a` 안은 다시 변환하지 않는다.
4단계: 코드 블록 — 가장 먼저 실행해야 한다
코드 블록은 쌓은 순서로는 마지막인데, 실행 순서로는 제일 앞이다. 코드 안의 #, -, **가 제목·목록·굵게 규칙에 걸리면 안 되기 때문이다.
post_markdown_inline(
    post_markdown_blocks(
        post_markdown_headings(
            post_markdown_tables(
                post_markdown_fences(HtmlSanitizer::clean($html))))))
여는 ``` ` 는 문단 시작에, 닫는 ` 는 문단 끝에 있어야 하고, 여러 <p>에 걸쳐도 된다. 언어(bash)는 class="language-bash"로 남긴다. 변환 뒤 내용은 strip_tags만 하고 **엔티티는 풀지 않는다.** 코드 안 <b>는 <b> 그대로 pre`에 들어간다. 이 선택이 뒤의 보안 이야기와 이어진다.
5단계: 표 — 파이프가 태그 속성에도 있다
표는 |로 시작·끝나는 줄 뒤에 |---|---| 구분 줄이 올 때만 <table>로 바꾼다. 첫 줄은 <th>, 나머지는 <td>. 이번에도 형식이 어긋나면 그대로 둔다.
처음엔 explode('|', …)로 칸을 나눴다. 이 부분이 보안 리뷰에서 걸렸다(2aaff6b). 셀 안에 <a href="/x" title="p | q">처럼 **속성 값에 |가 있으면** 태그가 칸 경계에서 잘려 마크업이 깨진다. 뒤에 >가 먼저 나오는 |는 태그 안이므로 경계가 아니라고 보게 했다.
// 태그 속성 안의 | (뒤에 > 가 먼저 오는 것)는 칸 경계가 아니다
$rows[] = array_map('trim', preg_split('/\|(?![^<>]*>)/u', substr($line, 1, -1)) ?: []);
같은 커밋에서 두 가지를 더 막았다.
- 데이터 줄의 칸이 머리글보다 많으면 초과 칸을 버리지 않고 변환을 포기한다. 조용히 데이터를 지우는 것보다 낫다.
- 열 32개, 행 200개를 넘으면 변환하지 않는다. 입력이 만드는 HTML 크기에 상한을 둔다.
같은 주간에 터진 일: 요약문에서 <script>가 되살아난다
마크다운 작업과 별개로, 같은 주에 RSS와 목록 요약을 점검하다가 XSS를 찾았다(#460). 요약문 함수 post_excerpt()는 본문 HTML에서 목록·메타 설명·RSS 설명용 글자를 뽑는다. 코드는 이랬다.
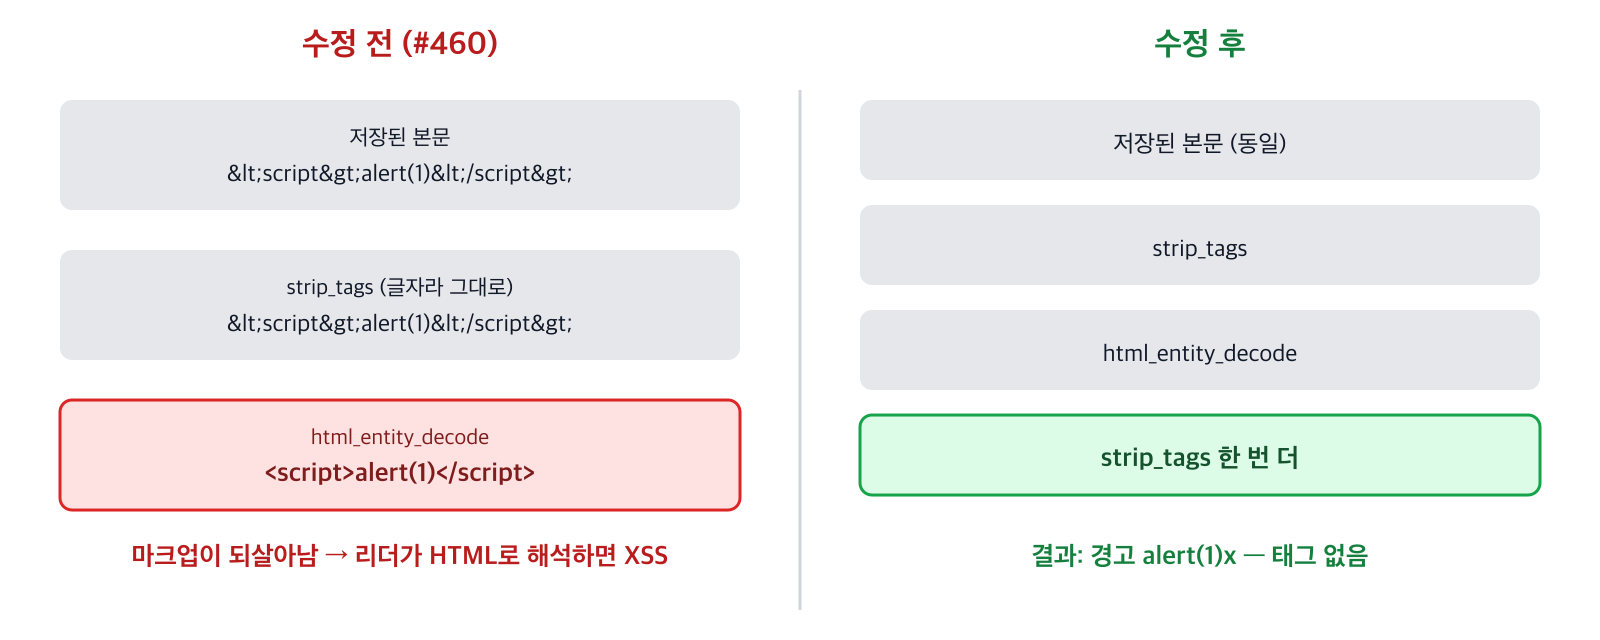
$text = html_entity_decode(strip_tags((string) $html), ENT_QUOTES | ENT_HTML5, 'UTF-8');이 순서는 #411 때 들어왔다. 목록 요약에 ·가 그대로 보이는 문제를 고치려고 엔티티를 풀기 시작한 것이다. 태그를 먼저 걷어내고 엔티티를 푸는 순서라 자연스러워 보인다. 하지만 본문에 <script>alert(1)</script>라는 글자가 있으면 이렇게 된다.
본문(저장)          경고 <script>alert(1)</script>x
strip_tags 후       경고 <script>alert(1)</script>x   ← 태그가 아니라 글자라 그대로
html_entity_decode 경고 <script>alert(1)</script>x ← 마크업으로 되살아남strip_tags는 이미 실행이 끝났다. 정화 뒤에 디코딩이 한 번 더 들어왔고, 그 결과물은 정화를 받지 못했다. RSS 피드는 <description>을 htmlspecialchars로 XML 이스케이프한다. 하지만 리더는 그 설명을 한 번 풀어 HTML로 렌더링하기도 한다. 그러면 사이트가 아니라 구독자의 리더 안에서 스크립트가 도는 경로가 열린다.
고친 방법: 디코딩 뒤에 한 번 더
가장 마지막 변환이 디코딩이면, 그 뒤에 정화가 한 번 더 있어야 한다.
// 엔티티를 푼 뒤 다시 태그를 걷어낸다 — <script> 가 풀려 마크업으로 되살아나면
// RSS 처럼 설명을 HTML 로 해석하는 소비자에서 XSS 가 된다
$text = strip_tags(html_entity_decode(strip_tags((string) $html), ENT_QUOTES | ENT_HTML5, 'UTF-8'));
수정 뒤 결과는 경고 alert(1)x다. 스크립트 태그는 사라지고 안쪽 글자만 남는다. 목록 요약·메타 설명·RSS가 모두 이 함수를 쓰므로 한 곳을 고치면 세 곳이 함께 막힌다. 회귀 테스트도 추가했다.
public function testExcerptDoesNotRevealEncodedTags(): void
{
// 엔티티로 인코딩된 태그가 풀려 마크업으로 되살아나면 안 된다
$this->assertSame('경고 alert(1)x', post_excerpt('<p>경고 <script>alert(1)</script>x</p>', 50));
}두 이야기가 만나는 지점
둘은 다른 이슈지만 같은 원칙이다.
- 디코딩은 신뢰 경계를 넘는 단계다.
<는 글자이고<는 마크업이다. 엔티티를 푸는 순간 입력의 의미가 바뀐다. 디코딩 뒤의 문자열은 정화를 받은 적이 없는 새 문자열이다. - 정화는 마지막 변환 뒤에 둔다. 렌더러에서 코드 블록은 엔티티를 풀지 않고
strip_tags만 했다. 요약문은 풀었기 때문에 한 번 더 걷어내야 했다. - 치환기는 만들 수 있는 출력을 좁혀 둔다. 허용 태그 목록, 링크 스킴 허용목록, 표 크기 상한, 실패하면 원문 유지. 정규식이 틀려도 최악이 "마크다운 기호가 보임"에 머문다.
정규식 렌더러는 마크다운 전체 문법을 지원하지 못한다. 중첩 목록이나 표 정렬 같은 것은 일부러 뺐다. 이 글을 쓰는 용도(Claude가 쓰는 문서 구조)에는 충분했고, 못 하는 것을 "원문 유지"로 안전하게 두는 쪽이 완전한 파서를 직접 짜는 쪽보다 유지보수가 쉬웠다.
댓글 0개