구글봇 화이트리스트에 GCP 대역을 넣었다가 발생한 보안 이슈와 교훈
시리즈 운영서버에서만 터진 버그 현재 위치 12 / 12
- 운영 배포에서만 실패한 slug 마이그레이션: 무음 실패를 실패로 보이게 만들기
- 운영 서버에서만 발생한 TinyMCE 이미지 경로 버그 3선
- 호스팅이 419를 500으로 바꿔버린 날
- 목록에 —가 그대로 찍혔다: strip_tags 다음에 빠진 한 단계
- 페이지 번호가 41개 전부 나왔다: AI가 만든 페이저 뷰에서 빠진 한 줄
- TinyMCE 이미지 alt가 사라지는 원인과 해결책
- 새로고침하면 공간이 사라진다: 저장 버튼을 의심하기 전에 순서를 봤다
- 큐 워커 운영 장애 연속극: systemd 워커가 안 도는 이유 체크리스트
- 문의 폼 봇 방어 5겹 스택, 실제로 뚫린 순서대로
- AI 실수 복구: 메인 체크아웃을 dev 상태로 되돌린 기록
- CMS 에디터가 내 CSS를 지웠다 — 소개 페이지 삽질기
- 구글봇 화이트리스트에 GCP 대역을 넣었다가 발생한 보안 이슈와 교훈
시리즈 PHP 취약점 대응 현재 위치 7 / 7
시리즈 AI 시대 보안 점검 현재 위치 11 / 11
- "깃헙에 시크릿이 노출됐습니다" 메일을 받았다 — 진짜 위험은 따로 있었다
- 사진 동선 앱에서 남의 사진이 보였다 — 위치 데이터를 다룰 때 놓치기 쉬운 것
- 멀티테넌트 API에서 company_id를 요청이 아니라 JWT에서 뽑는 이유 — AI 보안 리뷰로 재처리 API 뜯어보기
- iframe 하나로 격리하는 웹 채팅 위젯 설계
- AI가 만든 실제 실수 4가지 패턴과 교훈
- 스캐너 IP 자동 차단: 404 3회 일배치와 즉시 차단, 오차단 방어까지
- 리뷰 스팸을 AI로 감시할 때의 운영 규칙: 자동 삭제보다 검토 큐가 먼저인 이유
- 문의 폼 봇 방어 5겹 스택, 실제로 뚫린 순서대로
- Claude Vision으로 영수증·세금계산서 자동 장부 입력 구현
- 어르신들께 AI 목소리 사기를 어떻게 설명할까
- 구글봇 화이트리스트에 GCP 대역을 넣었다가 발생한 보안 이슈와 교훈
요약: 구글 서치 콘솔이 "403 때문에 색인할 수 없다"고 알려 와서, 스캐너 IP 자동 차단에 구글봇이 걸리지 않도록 구글이 공개한 대역 4개를 화이트리스트에 넣었다. 그런데 그중
34.64.0.0/13은 구글봇 전용이 아니라 GCP 공용 대역이어서, 클라우드를 빌린 누구나 차단을 피할 수 있는 구멍이 됐다. 같은 날 이 대역을 빼고 테스트를 뒤집어 고쳤고, "공개된 대역"과 "신뢰할 수 있는 대역"은 다르다는 교훈을 남겼다.
발단: 서치 콘솔의 403 색인 오류
시작은 구글 서치 콘솔이었다. 색인 보고서에 403 응답 때문에 페이지를 색인하지 못한다는 항목이 나왔다. 사이트는 정상적으로 열리는데 구글봇만 403을 받고 있었다.
배경: 차단 IP 목록에서 구글봇을 지켜야 했다
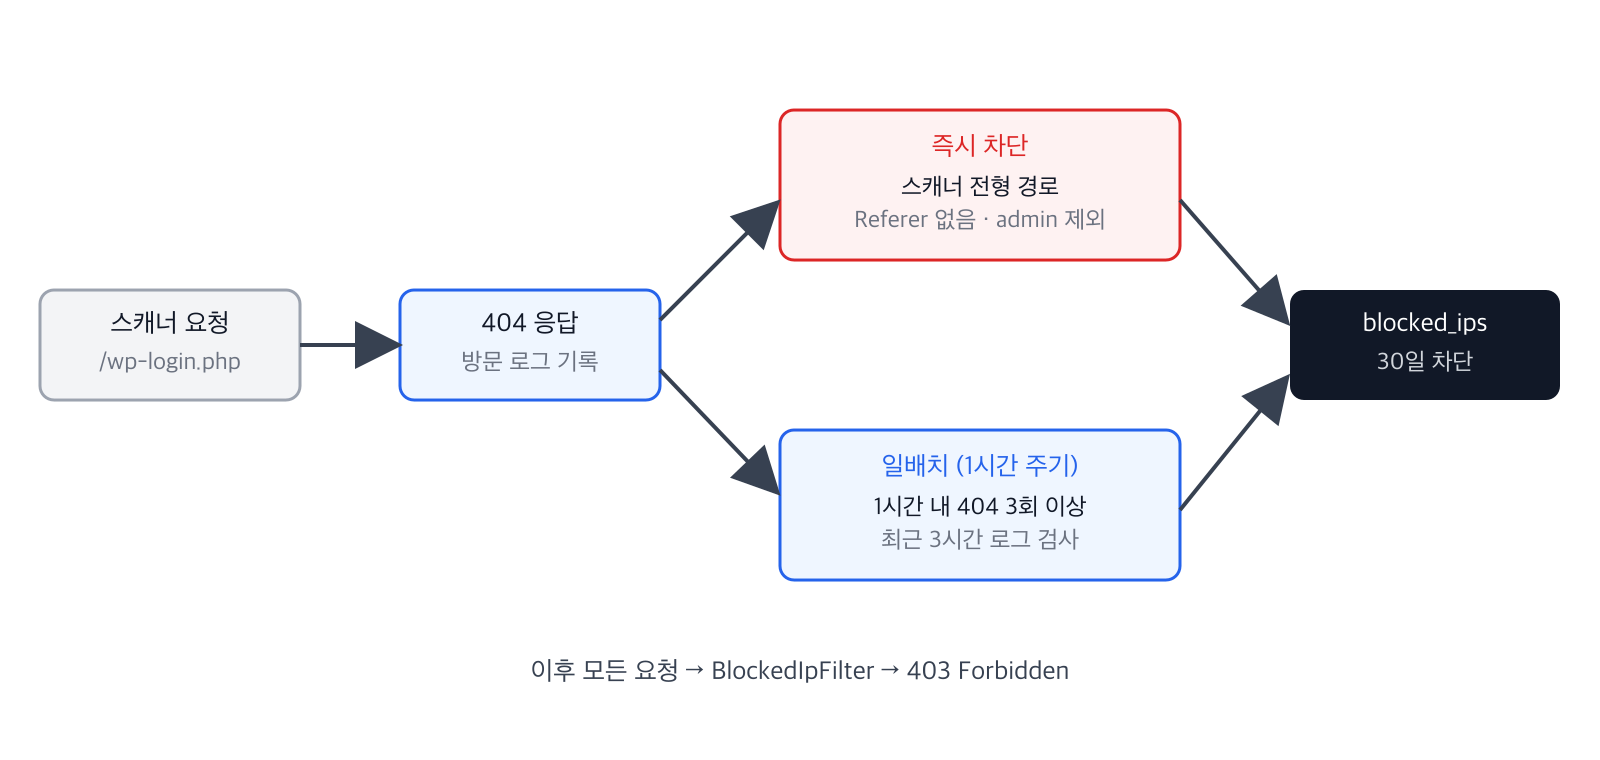
공개 사이트에는 404 로그 기반으로 스캐너 IP를 자동 차단하는 장치를 두고 있다(이전 글: 스캐너 IP 자동 차단). 차단된 IP는 403을 받는다. 이 장치가 크롤러까지 막을 수 있다는 점이 문제다. 구글봇이 차단되면 색인이 안 되고 검색 노출에 직접 영향이 간다. 서치 콘솔의 403은 이 차단에 구글봇이 걸린 것으로 보고 대응했다.
실제로 차단 목록을 열어 보니 34.64.* 대역 IP가 8개 들어 있었다. 구글이 크롤링에 쓰는 GCP 대역이라, 구글봇이 스캐너로 오인돼 차단된 것으로 판단했다.
해제한 뒤 서치 콘솔의 403 오류는 해소됐고, 색인 재요청도 넣었다. 8개 IP가 원인이었다는 판단이 맞았다.
그래서 이슈를 하나 만들었다. 요청은 두 가지였다.
- 구글봇 IP 대역 4개를 화이트리스트에 등록한다.
- 차단 IP 검색에서
*를 와일드카드로 쓸 수 있게 한다. 정확히 일치하는 IP만 검색돼서 찾을 수가 없었다.
이슈에 적은 대역은 다음과 같았다.
66.249.64.0/19   구글봇의 대표 대역
34.64.0.0/13     Google Cloud 인프라를 경유하는 크롤러 대역
34.22.85.0/27
192.178.4.0/22
구현: 단일 IP 비교를 CIDR 비교로
기존 화이트리스트는 .env의 security.ipWhitelist에 쉼표로 적은 단일 IP를 in_array로 비교할 뿐이었다. CIDR을 처리하려면 비교 방식을 바꿔야 했다. inet_pton()으로 IP를 바이트열로 바꾸고, 접두사 비트만큼만 비교하는 IpRange 클래스를 만들었다. IPv4와 IPv6를 모두 처리한다.
public static function containsAny(string $ip, iterable $ranges): bool
{
    $packed = inet_pton($ip);

    if ($packed === false) {
        return false;
    }

    foreach ($ranges as $range) {
        $parts        = explode('/', $range, 2);
        $subnetPacked = inet_pton($parts[0]);

        // 주소 계열(IPv4/IPv6)이 다르면 건너뛴다
        if ($subnetPacked === false || strlen($subnetPacked) !== strlen($packed)) {
            continue;
        }

        $bits = isset($parts[1]) ? (int) $parts[1] : strlen($packed) * 8;

        if (self::matchesPrefix($packed, $subnetPacked, $bits)) {
            return true;
        }
    }

    return false;
}BlockedIpModel::isWhitelisted()는 내장한 구글봇 대역과 .env의 목록을 합쳐 이 함수로 검사한다.
return IpRange::containsAny($ipAddress, [...self::GOOGLEBOT_RANGES, ...$list]);검색 와일드카드는 사용자가 입력한 *를 SQL LIKE의 %로 바꾸되, %와 _는 먼저 이스케이프했다. 그렇지 않으면 검색어에 든 _가 임의의 한 글자로 해석된다. 앞뒤는 항상 부분 일치로 두었다.
// 앞뒤는 항상 부분 일치, 입력한 `*` 는 중간 와일드카드로 쓴다.
$escaped = str_replace(['\\', '%', '_'], ['\\\\', '\\%', '\\_'], $keyword);
$builder->where('ip_address LIKE', '%' . str_replace('*', '%', $escaped) . '%');
이제 195.178.110.*로 검색하면 195.178.110.199가 나온다. 테스트를 붙이고 PR을 머지했다.
문제: 대역 하나가 나머지 전부보다 훨씬 컸다
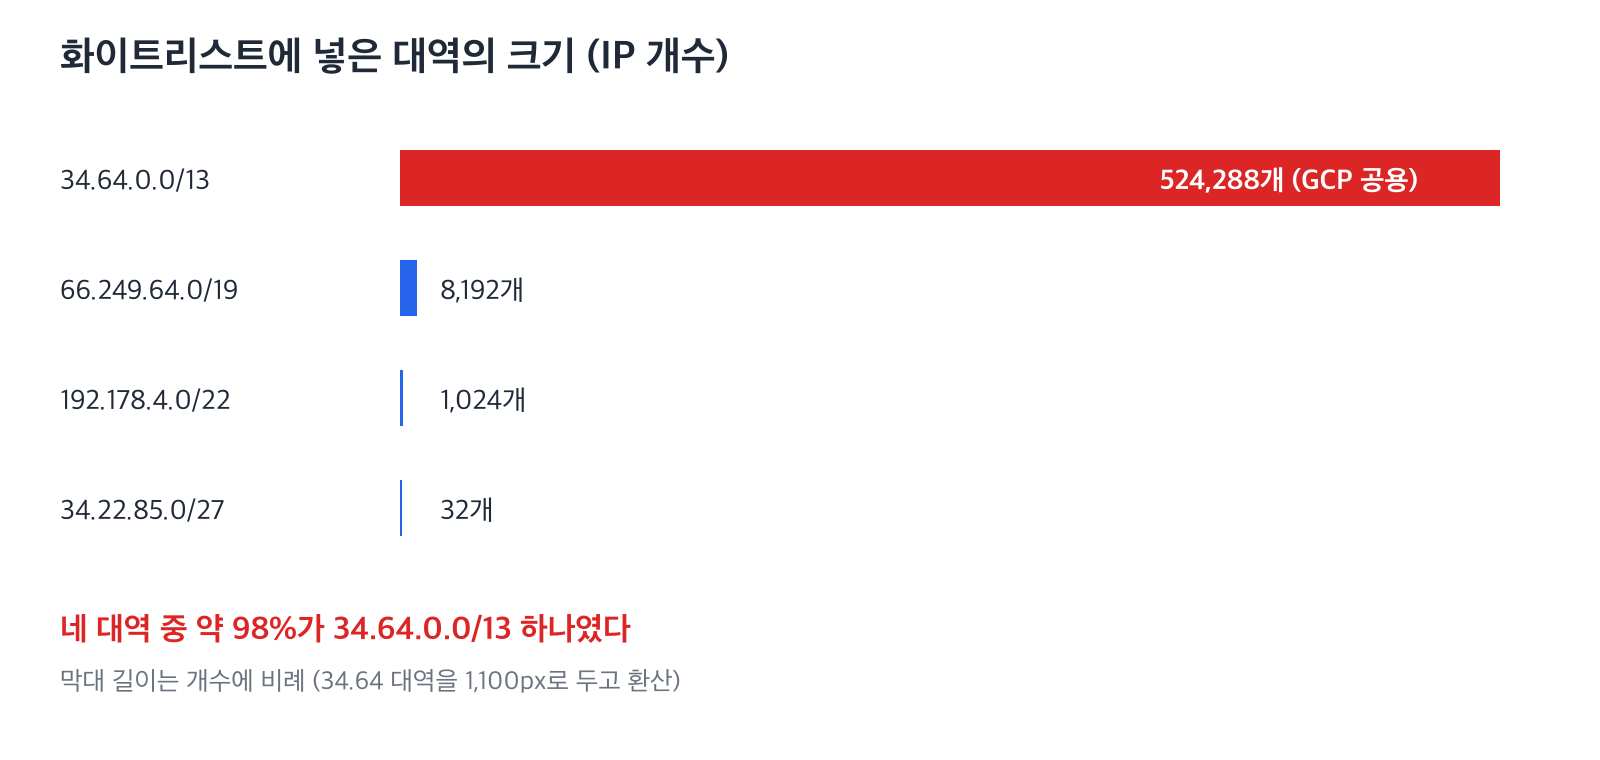
작업 요약을 이슈에 남기면서 구현 내용을 다시 읽다가 걸렸다. 34.64.0.0/13은 구글봇이 쓰는 대역이 아니라 GCP(Google Cloud) 전체 고객이 쓰는 공용 대역이었다. 이 대역에서 나오는 요청이 전부 구글봇은 아니다. GCP에 VM을 빌린 사람이면 누구나 이 대역의 IP를 받는다.
크기를 비교하면 차이가 분명하다. /13은 524,288개, /19는 8,192개다. 화이트리스트에 넣은 네 대역 중 약 98%가 이 하나였다.
화이트리스트가 면제하는 범위도 문제를 키웠다. isWhitelisted()는 block()에서 쓰이는 데 그치지 않고 isBlocked()에서도 쓰인다. 즉 이 대역의 IP는 자동 차단만 피하는 게 아니라, 관리자가 직접 등록한 수동 차단도 무시됐다.
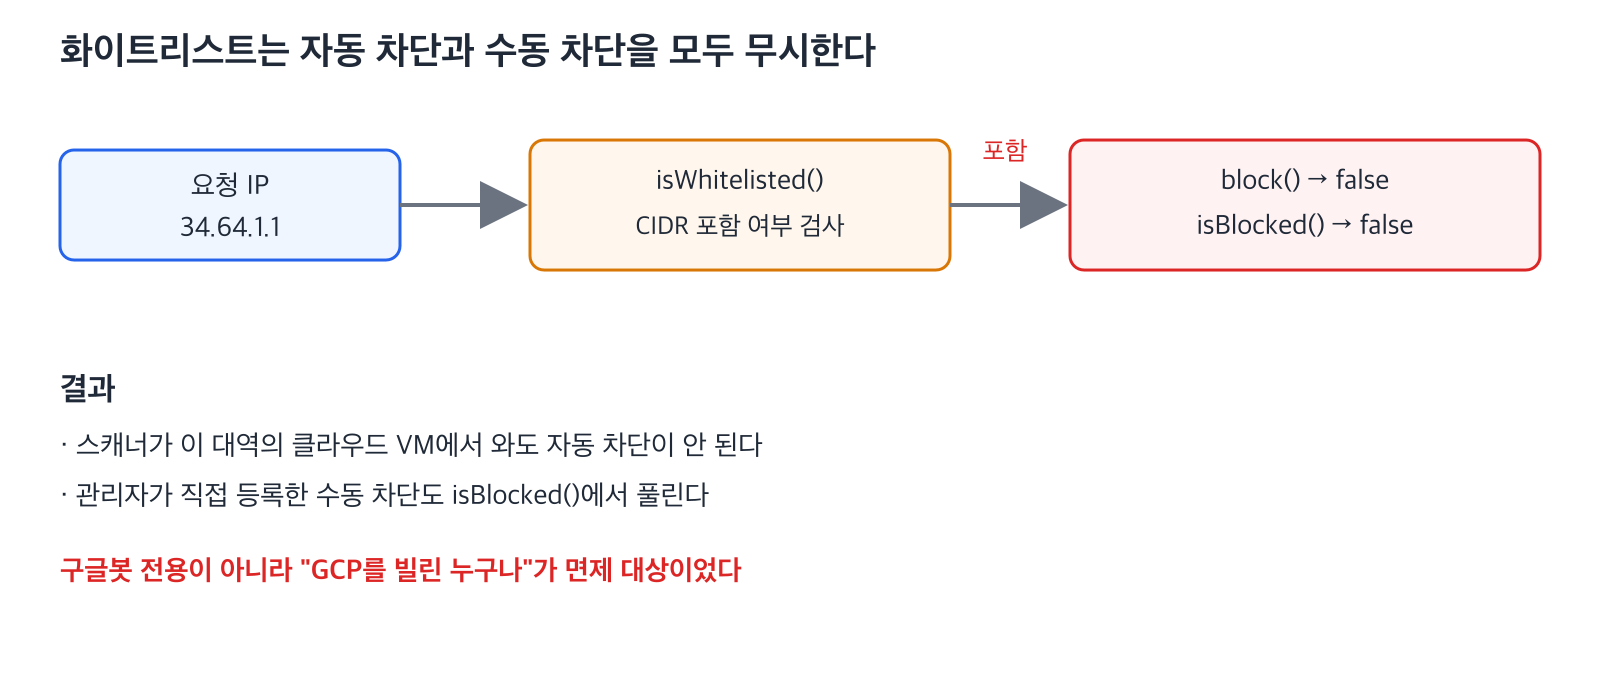
결과적으로 GCP VM에서 스캐너를 돌리면 우리 차단 장치를 통과하는 구조였다. 구글봇을 보호하려던 기능이 공격자에게 우회로를 준 셈이다.
해결: 대역을 빼고 테스트를 뒤집었다
수정은 한 줄이었다. GOOGLEBOT_RANGES에서 34.64.0.0/13을 지웠다.
private const GOOGLEBOT_RANGES = [
    '66.249.64.0/19',
    '34.22.85.0/27',
    '192.178.4.0/22',
];
더 중요한 건 테스트였다. 원래 테스트는 34.64.1.1이 차단되지 않음을 확인했다. 이걸 "이 대역은 차단된다"는 단언으로 바꿔서, 누군가 나중에 같은 대역을 다시 넣으면 테스트가 깨지게 했다.
foreach (['66.249.66.1', '34.22.85.30', '192.178.5.9'] as $ip) {
    $this->assertFalse($model->block($ip, BlockedIpModel::REASON_AUTO), $ip);
}
// GCP 공용 대역은 구글봇이 아니므로 차단되어야 한다
$this->assertTrue($model->block('34.64.1.1', BlockedIpModel::REASON_AUTO));
운영 대응: 이미 차단된 8개는 수동으로 풀었다
코드를 고쳐도 이미 목록에 들어간 IP는 그대로다. 차단 목록에 있던 34.64.* 대역 8개는 관리자 화면에서 수동으로 해제했다. 이때 같은 이슈에서 만든 와일드카드 검색이 쓸모 있었다. 34.64.*로 검색하면 해당 대역만 한 번에 모인다.
34.64.0.0/13을 화이트리스트에서 뺐으니, 이 대역의 구글 크롤러가 스캐너로 오인되면 앞으로도 자동 차단될 수 있다. 이 부분은 자동화하지 않고 운영으로 풀기로 했다. 서치 콘솔에서 403 오류가 다시 보이면 차단 목록에서 34.64.*를 검색해 수동 해제한다.
구글봇을 지키는 것과 GCP 전체에 구멍을 내지 않는 것은 서로 트레이드오프라서, 면제 범위를 좁히는 대신 오탐은 사람이 푸는 쪽을 택했다.
배운 점
- 공개된 대역이라고 신뢰할 수 있는 건 아니다. 클라우드 사업자의 대역에는 그 회사의 서비스뿐 아니라 고객의 서버도 섞여 있다. 화이트리스트에는 "그 서비스만" 쓰는 대역만 넣어야 한다.
- 화이트리스트를 넣을 때는 크기부터 본다. CIDR 접미사 하나(
/13vs/19)가 면제 대상을 64배 키운다. 목록에서 유독 큰 항목이 있으면 의심한다. - 면제는 어디까지 적용되는지 확인한다. 이번에는 자동 차단뿐 아니라 수동 차단까지 풀렸다. 예외 규칙은 적용 범위가 넓을수록 위험하다.
- 정말 구글봇인지 확인하려면 IP 대역보다 역방향 DNS 검증이 더 정확하다. 구글 문서가 안내하는 방식(IP를 역조회해
googlebot.com도메인인지 보고, 그 이름을 정방향 조회해 같은 IP인지 확인)이다. 이번에는 적용하지 않았다. - 보안 장치는 검색 노출에 부작용을 낸다. 자동 차단은 스캐너뿐 아니라 구글봇도 403으로 막을 수 있다. 차단 로직을 넣었다면 서치 콘솔의 크롤링·색인 오류를 주기적으로 확인한다.
- 실수를 만든 순간이 아니라 작업 요약을 쓰다가 발견했다. 이슈에 쓰는 요약이 사실상 두 번째 리뷰 역할을 했다.
댓글 0
아직 댓글이 없습니다. 첫 댓글을 남겨 보세요.